MATHEMATICAL MODEL AND METHODOLOGY OF AUTOMATED ANALYSIS OF INFORMATION SECURITY RISKS FOR EDUCATIONAL INSTITUTIONS
Введение
В условиях стремительной цифровизации социально-экономических процессов и усложнения архитектуры информационных систем (ИС) проблема обеспечения информационной безопасности (ИБ) приобретает стратегическое значение. Рост числа целевых кибератак, повышение профессионализма нарушителей, а также внедрение облачных технологий, распределенных вычислений и больших данных формируют новую матрицу угроз, требующую оперативного и объективного управления рисками. Актуальным направлением исследований является разработка формализованных и автоматизированных подходов к оценке актуальности угроз и оценке рисков ИБ, исключающих субъективность экспертных оценок и минимизирующих временные затраты на проведение анализа [1].
Нормативно-правовая база Российской Федерации в области ИБ [2–4] предъявляет жесткие требования к процессам категорирования, оценки угроз и выбора контрмер. Однако на практике большинство организаций продолжают использовать ручные или полуавтоматизированные методы анализа, основанные на опросниках и статических таблицах. Такие подходы характеризуются высокой трудоемкостью, низкой воспроизводимостью результатов, трудностями в динамическом обновлении базы угроз и сложностью согласования требований регуляторов с фактическим состоянием защиты [5].
В связи с этим возникает научная и практическая потребность в создании математической модели процесса оценки рисков, вычислительного метода и основанной на них методики, интегрирующей количественные и качественные методы оценки рисков, формализующей процессы выбора мер защиты в соответствии с актуальными нормативными требованиями и реализующей вычислительные процедуры в виде программного средства с интуитивно понятным интерфейсом. Среди зарубежных подходов к анализу рисков ИБ получили распространение: методология факторного анализа информационных рисков FAIR™ (Factor Analysis of Information Risk), обеспечивающая количественную оценку рисков в денежном эквиваленте [6]; база знаний MITRE ATT&CK, систематизирующая тактики и техники реальных кибератак для построения сценариев угроз [7]; а также аналитические отчеты и руководства Агентства Европейского союза по кибербезопасности (ENISA)1, формирующие методологическую основу для оценки рисков. В российских условиях наибольшее распространение получили методики, основанные на требованиях ФСТЭК России и стандартах ГОСТ Р ИСО/МЭК 27005 [3].
В настоящей работе представлены математическая модель процесса оценки рисков, вычислительный метод и методика автоматизированного анализа рисков, апробированные на информационной системе образовательной организации – Оренбургского государственного университета имени В. А. Бондаренко. Выбор объекта апробации обусловлен наличием разветвленной IT-инфраструктуры, обрабатывающей конфиденциальную информацию различного рода, в том числе персональные данные значительного контингента обучающихся и сотрудников, а также необходимостью соблюдения требований регуляторов в сфере образования. Архитектура разработанного программного комплекса предусматривает возможность его дальнейшей адаптации для организаций других отраслей за счет применения отраслевых коэффициентов в реляционной базе данных угроз.
Цель исследования – разработка математической модели процесса оценки рисков информационной безопасности, вычислительного метода ее реализации и методики автоматизированного анализа рисков, обеспечивающих детерминированный расчет интегрального уровня риска и формирование рекомендаций по его снижению в соответствии с российскими стандартами, и их экспериментальная проверка.
Для достижения цели решались следующие задачи: формализация процесса оценки рисков в виде математической модели; разработка вычислительного метода (расчет, нормализация и ранжирование рисков, калибровка экспертных коэффициентов, анализ чувствительности модели); формулировка методики в виде последовательности этапов с указанием используемых выражений модели; программная реализация и апробация на информационной системе образовательной организации.
Материалы и методы исследования
Задача анализа и оценки вероятности реализации угроз и рисков ИБ исследована многими учеными. В основном используются качественные, количественные и гибридные методы [8, 9]. В статье [10] обоснована необходимость применения гибридного подхода к оценке рисков для АСУ ТП как объектов критической информационной инфраструктуры (КИИ). Авторы отмечают, что качественные методы, основанные на экспертных оценках, обеспечивают полноту анализа, гибридный подход позволяет перевести лингвистические переменные в числовые шкалы, сохранив преимущества обоих методов [11, 12]. Авторы работы [13] в исследовании рисков коммерческого банка также применяют экспертные методы, дополняя их теорией марковских процессов и математической статистикой. Особое внимание уделено оценке работ по восстановлению системы после инцидента, что критично для финансовых организаций с высокими требованиями к доступности [14]. В работе [15] оценка риска производится на основе технологий машинного обучения. Авторы рассматривают методики оценки рисков с учетом коэффициентов, отражающих отраслевую специфику, например медицинские ИС, в которых приоритетом является защита персональных данных, и масштаб системы, предлагая формальную модель оценки рисков с использованием теоретико-множественного аппарата, что позволяет учитывать взаимосвязи между уязвимостями компонентов системы [16, 17]. Все рассмотренные работы подчеркивают важность адаптации методик к особенностям защищаемого объекта: для банков ключевыми факторами являются финансовые потери, репутационные риски и требования регуляторов, для объектов критической информационной инфраструктуры приоритет отдается безопасности технологических процессов, где ущерб может включать экологические катастрофы и человеческие жертвы [18].
На основе анализа научных публикаций по теме оценки рисков ИБ выявлены следующие тенденции:
− переход к риск-ориентированному подходу – оценка рисков становится основой для адаптации базовых наборов мер защиты, а не формальным требованием;
− автоматизация оценки с применением координатно-графового метода [19];
− учет производственного контекста с проведением оценки эффективности систем защиты [20];
− использование нечеткой логики и экспертных систем позволяет работать с неполными данными и сохранять интерпретируемость результатов.
Исследование построено в соответствии с тремя составляющими прикладного математического моделирования: математической моделью, вычислительным методом и комплексом программ. Математическая модель описывает процесс оценки рисков информационной безопасности (ИБ) с помощью множеств, отображений и расчетных соотношений (выражения (1)–(12), табл. 1). Вычислительный метод включает алгоритм расчета и ранжирования рисков, модифицированную Min-Max нормализацию, метод взвешенных сумм, оценку вычислительной погрешности, калибровку экспертных коэффициентов и анализ чувствительности модели (выражения (13)–(20), табл. 2–5). Программный комплекс реализует модель и метод в автоматизированном режиме. Методика автоматизированного анализа рисков ИБ представлена как последовательность этапов, для каждого из которых указаны используемые выражения модели и процедуры вычислительного метода (табл. 6). Таким образом, математическая модель является составной частью методики, но не отождествляется с ней.
Математическая модель процесса оценки рисков информационной безопасности
Теоретическую основу математической модели составили принципы риск-менеджмента ИБ, изложенные в [2, 21, 22], регламентирующие порядок выявления угроз, категорирования объектов и применения базового набора мер защиты. Также были рассмотрены международные стандарты информационной безопасности [23–25] и методология моделирования угроз безопасности [26]. Для задания параметров модели используется метод экспертных оценок.
Моделируемым процессом является формирование интегрального уровня риска информационной системы (ИС) организации: по входным данным пользователя (тип организации, состав активов, масштаб ИС и организации, оценки возможного ущерба, статусы реализации мер защиты) для каждой выявленной угрозы ui рассчитывается Ri – интегральный уровень риска i-й угрозы, а затем общий риск ИС Rtotal. В качестве рассматриваемых организаций взяты восемь сфер деятельности, тестирование проводилось на примере образовательного учреждения – университета. Для организаций из различных сфер деятельности характерно, что различные угрозы имеют различную частоту, для учета данного фактора используется γ – отраслевой коэффициент частоты реализации угрозы ui в конкретном типе организации. Возможный ущерб (нарушение конфиденциальности, целостности, доступности) оценивается пользователем по шкале L/M/H и используется для определения класса защищенности ИС; ожидаемый ущерб Si от реализации угрозы рассчитывается по выражению (8). Коэффициент α – масштаб ИС (федеральный/региональный/объектовый), необходим для определения класса защищенности ИС; β – коэффициент масштаба организации, влияющий на масштаб ущерба; ψim(xm) – корректирующий коэффициент, учитывающий степень реализации мер защиты и класс сертификации используемых средств защиты информации (СЗИ) в соответствии с требованиями нормативных документов. Итоговая вероятность реализации угрозы Pi определяется как произведение базовой вероятности реализации угрозы, отраслевого коэффициента и эффективных весов реализованных мер защиты. Диапазоны изменения коэффициентов приведены в табл. 1.
Таблица 1
Математическая модель процесса оценки рисков информационной безопасности
|
Этап |
Формула (номер) |
Характеристика данных |
|
Этап 1. Идентификация активов и их ценности |
оценивается в баллах |
A – множество активов ИС организации (информационных, программных, аппаратных), которое определяется ответами пользователя; m – количество активов, находящихся в ИС; C(a) – ценность актива, a – целое число |
|
Этап 2. Идентификация угроз и их связь с активами и отраслевыми коэффициентами |
N = 155
γ0отр ∈ [0.5,2] (6) Kотрia ∈ [0.5,2],
|
U – множество угроз; N – количество угроз, оставшихся после фильтрации из исходного набора БДУ ФСТЭК (227 угроз) по критерию отсутствия в ИС суперкомпьютерных, облачных и ИИ-компонентов; Ai – подмножество активов, которые может затронуть угроза ui; P0i – базовая вероятность реализации угрозы (экспертная константа исходя из статистики); γ0отр – отраслевой коэффициент частоты встречаемости угрозы ui в конкретном типе организации (экспертная константа) Kотрia – отраслевой коэффициент ущерба, отвечающий, насколько критично нарушение актива a, атакованного угрозой ui |
|
Этап 3. Оценка ущерба |
|
Si – ожидаемый ущерб от реализации угрозы ui (в баллах); α – коэффициент масштаба ИС; β – коэффициент масштаба организации, вычисляемый по входным данным пользователя (1.0/1.5/2.0). |
|
Этап 4. Оценка вероятности реализации угрозы |
|
Pi – итоговая вероятность реализации угрозы (0…1); Ki – количество факторов уязвимости для угрозы i; Mi – количество реализованных мер защиты для угрозы i; φi,k(xk) – коэффициент увеличения вероятности, активируемый ответом пользователя xk, указывающий на наличие уязвимости (экспертная оценка ≥ 1); ψim(xm) – коэффициент уменьшения вероятности, активируемый ответом пользователя xm (m=1,…, Mi), указывающий на наличие защитной меры (экспертная оценка ≤ 1); произведения по k и m охватывают все ответы, влияющие на i угрозу |
|
Этап 5. Расчет риска |
|
Ri – абсолютный риск угрозы ui (в баллах), Rmax – верхняя граница нормализации (экспертная оценка), которая ограничивает Ri сверху для перевода в проценты; Ri% – риск от угрозы ui в % |
|
|
Rtotal – общий риск информационной системы [0, 100]% |
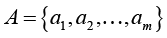 (1)
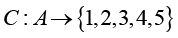 , (2)
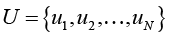 (3)
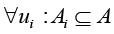 (4)
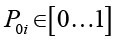 (5)
 (7)
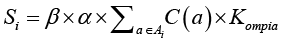 (8)
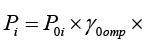
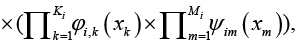 (9)
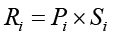 (10)
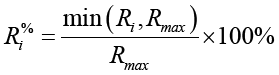 (11)
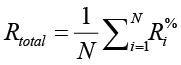 (12)
Примечание: составлена авторами на основе полученных данных в ходе исследования.
Для формализации процесса оценки рисков в модели выделено пять расчетных этапов (табл. 1): идентификация активов и их ценности; идентификация угроз и их связь с активами и отраслевыми коэффициентами; оценка ущерба; оценка вероятности реализации угрозы; расчет риска. Ранжирование угроз и формирование рекомендаций выполняются вычислительным методом и методикой (табл. 6). База угроз сформирована на основе Банка данных угроз ФСТЭК России, дата выгрузки 10.02.2026, последнее обновление для данной даты 08.02.2026 г. Банк данных угроз регулярно обновляется, поэтому была взята версия актуальная на дату обращения, включающая в себя 227 угроз [27]. Выбор пакета анализируемых угроз основан на типе анализируемых информационных систем, в качестве которых рассматривались ГИС, иные ИС, ИСПДн. Фильтром отбора угроз являлись виды объектов воздействия угроз, отсутствие в этих ИС суперкомпьютеров, облачных сервисов и ИИ-компонентов. Пример исключенной угрозы: УБИ.029 Угроза использования вычислительных ресурсов суперкомпьютера «паразитными» процессами, УБИ.020 Угроза злоупотребления возможностями, предоставленными потребителям облачных услуг. База данных угроз может быть расширена при дальнейшем совершенствовании программы.
Оценка соответствия уровня защиты нормативным требованиям выполняется в автоматическом режиме согласно [2] с определением класса защищенности ИС (К1, К2, К3) и минимально требуемого класса и уровня доверия сертифицированных средств защиты информации (СЗИ). В табл. 1 представлена математическая модель процесса оценки рисков ИБ (выражения (1)–(12)).
Модель (1)–(12) является детерминированной и мультипликативной. Ожидаемый ущерб (8) определяется взвешенной суммой ценностей затронутых активов C(a) с отраслевыми весами Kотрia, умноженной на коэффициенты масштаба α и β. Итоговая вероятность реализации угрозы (9) формируется как произведение базовой вероятности P0i, отраслевого коэффициента γ0отр и корректирующих коэффициентов φi,k(xk) (увеличивают вероятность при наличии уязвимости, φ ≥ 1) и ψim(xm) (уменьшают вероятность при наличии меры защиты, ψ ≤ 1). Риск угрозы (10) равен произведению вероятности и ущерба, нормализованное значение риска (11) приводится к шкале от 0 до 100 %, общий риск ИС (12) вычисляется как среднее нормализованных рисков по всем N угрозам. Входными данными модели являются множество активов A с оценками C(a), коэффициенты масштаба α, β и ответы пользователя xk, xm; выходными – значения Ri%, Rtotal и ранжированный перечень угроз (13).
Вычислительный метод
Для реализации математической модели (1)–(12) разработан вычислительный метод, включающий пять процедур: расчет и ранжирование рисков по модели; нормализацию рисков; оценку вычислительной погрешности; калибровку экспертных коэффициентов; анализ чувствительности модели к изменению входных параметров.
Используются численные методы расчета: модифицированный метод Min-Max нормализации в фиксированном диапазоне с экспертным ограничением максимального значения и метод взвешенных сумм (Weighted Sum Model, WSM), который относится к группе методов многокритериального принятия решений. Для расчета частных показателей, таких как ущерб от угрозы (8), используется метод взвешенных сумм с применением экспертных и отраслевых коэффициентов.
Алгоритм расчета и ранжирования
Для заданных входных данных расчет выполняется за один проход без итераций.
1. По типу организации из реляционной базы данных загружаются отраслевые коэффициенты γ0отр и Kотрia, по анкете определяются множество активов A, ценности C(a), коэффициенты α, β и ответы пользователя.
2. Для каждой угрозы ui, i = 1,…,N последовательно вычисляются Si по (8), Pi по (9), Ri по (10) и Ri% по (11).
3. По выражению (12) вычисляется общий риск Rtotal.
4. Угрозы упорядочиваются по убыванию нормализованного риска, то есть находится перестановка π, для которой
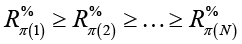 , (13)
и формируется перечень T10={uπ(1),…,uπ(10)} из десяти наиболее критичных угроз. Вычислительная сложность расчета рисков линейна по числу угроз N, ранжирования – O(N log N).
Нормализация рисков
Для приведения итогового риска к шкале от 0 до 100 % применялся метод Min-Max нормализации с экспертным ограничением. Вычислительный метод является детерминированным: вместо случайного моделирования используется аппарат взвешенных сумм и мультипликативных моделей с жестко заданными отраслевыми и масштабирующими коэффициентами.
Таблица 2
Сравнение классического и модифицированного методов нормализации
|
Показатель |
Классический Min-Max |
Модифицированный Min-Max |
|
Максимальное значение Ri в выборке, балл |
387,4 |
387,4 |
|
Динамический |
387,4 |
– |
|
Фиксированный |
– |
400 |
|
Среднее нормализованное значение, % |
42,3 |
40,8 |
|
Медиана нормализованного значения, % |
31,7 |
30,5 |
|
Стандартное отклонение нормализованных значений, % |
28,1 |
27,0 |
|
Количество угроз с нормализованным значением > 90 % |
3 |
2 |
|
Разброс нормализованных значений (max – min), п. п. |
100,0 |
96,9 |
|
Изменение ранжирования топ-10 угроз при добавлении экстремального значения (R = 620) |
4 перестановки |
0 перестановок |
|
Время вычисления 155 нормализаций, мс |
0,012 |
0,011 |
 >
Примечание: составлена авторами на основе полученных данных в ходе исследования.
Таблица 3
Результаты численного эксперимента по оценке воспроизводимости
|
Показатель |
Значение |
|
Максимальное отклонение Ri между прогонами, балл |
0,0 |
|
Максимальное отклонение нормализованного значения Ri, % |
0,0 |
|
Максимальное отклонение общего риска Rtotal, % |
0,0 |
|
Количество прогонов с различным ранжированием топ-10 |
0 из 1000 |
|
Теоретическая верхняя граница погрешности |
ε ≈ 2,22·10–16 |
|
Наблюдаемая погрешность |
0,0 (ниже порога отображения) |
Примечание: составлена авторами на основе полученных данных в ходе исследования.
Для подтверждения работоспособности модифицированного метода нормализации проведен численный эксперимент на основе данных 155 угроз, полученных в ходе апробации на информационной системе ОГУ им. В. А. Бондаренко. Классический метод нормализации определяется формулой
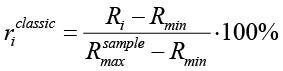 , (14)
где 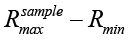 определяется динамически по выборке. Модифицированный метод определяется формулой
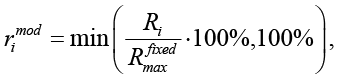
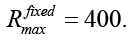 (15)
Результаты сравнения на одних и тех же входных данных представлены в табл. 2.
Ключевой результат: при добавлении в выборку единственной экстремальной угрозы (Ri = 620 баллов, что превышает  ) классический метод приводит к «сжатию» шкалы: все остальные значения уменьшаются пропорционально новому максимуму, и четыре угрозы из топ-10 меняют свое ранжирование. Модифицированный метод обрезает экстремальное значение до 100 %, не влияя на распределение остальных рисков (0 перестановок в топ-10).
Оценка вычислительной погрешности
Для проверки утверждения об ограничении погрешности машинным эпсилоном проведен численный эксперимент: расчет рисков для идентичных входных данных выполнен 1000 раз последовательно. Результаты представлены в табл. 3.
Нулевое отклонение объясняется детерминированностью алгоритма: отсутствуют итерационные процедуры, генераторы случайных чисел и условные ветвления, зависящие от состояния. Утверждение о машинном эпсилоне подтверждено численно, а не только теоретически.
Анализ чувствительности модели
Анализ выполнен методом «одного изменения» (one-at-a-time): каждый входной параметр θj (из числа P0i, γ0отр, β, α, C(a), φi,k, ψim, Rmax) последовательно варьировался в заданном диапазоне при фиксированных базовых значениях остальных параметров. Пусть θ0 – вектор базовых значений параметров, θ(j) – вектор, в котором изменен только j-й параметр. Изменения риска i-й угрозы и общего риска ИС определяются выражениями
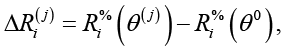 (16)
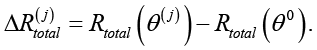 (17)
Показатели чувствительности, приведенные в табл. 4 (среднее и максимальное изменение риска угрозы), вычисляются по выражению
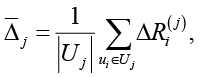
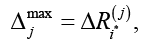
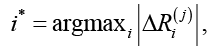 (18)
где Uj – множество угроз, на оценку которых влияет параметр θj. Изменения выражены в процентных пунктах. Результаты представлены в табл. 4.
Наибольшую чувствительность модель демонстрирует к коэффициенту масштаба организации β (переход от объектового к федеральному масштабу увеличивает средний риск на 12,5 п. п.). Наименее чувствительна модель к весам мер защиты ψim(xm), что подтверждает корректность экспертной калибровки: защитные меры снижают риск, но не являются доминирующим фактором по сравнению с масштабом системы.
Таблица 4
Анализ чувствительности модели к изменению входных параметров
|
Варьируемый параметр |
Диапазон изменения |
Среднее изменение Ri, п. п. |
Максимальное изменение Ri, п. п. |
Среднее изменение Rtotal, п. п. |
|
Базовая вероятность P0i |
±20 % |
±3,2 |
±7,8 |
±1,4 |
|
Отраслевой коэффициент γ0отр |
±30 % |
±4,1 |
±9,6 |
±1,9 |
|
Коэффициент масштаба β |
1,0 → 2,0 |
+12,5 |
+28,3 |
+12,5 |
|
Коэффициент масштаба ИС α |
1,0 → 1,4 |
+9,8 |
+21,4 |
+9,8 |
|
Ценность актива C(a) |
±1 балл |
±5,4 |
±11,2 |
±2,3 |
|
Вес уязвимости φ |
±25 % |
±2,8 |
±6,1 |
±1,2 |
|
Вес мер защиты ψim(xm) |
±25 % |
−2,1 |
−5,3 |
−0,9 |
|
|
350 → 400 |
±3,7 |
±8,4 |
±1,6 |
Примечание: составлена авторами на основе полученных данных в ходе исследования$
п. п. – процентный пункт (абсолютное изменение показателя, выраженного в процентах).
Таблица 5
Устойчивость модифицированного метода к экстремальным значениям
|
Добавленная экстремальная угроза, Ri , балл |
Нормализованное значение экстремальной угрозы, % |
Изменение среднего по остальным 155 угрозам, п. п. |
Изменение ранжирования топ-10 |
|
400 (= |
100,0 |
0,0 |
Нет |
|
500 |
100,0 (обрезание) |
0,0 |
Нет |
|
620 |
100,0 (обрезание) |
0,0 |
Нет |
|
1000 |
100,0 (обрезание) |
0,0 |
Нет |
Примечание: составлена авторами на основе полученных данных в ходе исследования.
Устойчивость к экстремальным значениям
Для оценки устойчивости в выборку последовательно добавлялись угрозы с искусственно завышенными значениями Ri. Результаты представлены в табл. 5.
Функция обрезания (·min100%) гарантирует, что ни одна экстремальная угроза не влияет на нормализованные значения остальных. Это подтверждает липшицевость функции нормализации с константой L = 100/400 = 0,25: для любых Ra, Rb ∈ [0;+∞] выполняется
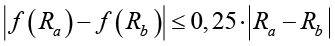 ,
что исключает лавинообразный рост ошибок.
Модифицированный метод Min-Max нормализации с фиксированной верхней границей отличается от классического метода, где максимум определяется динамически по выборке, в разработанной методике задана экспертная константа Rmax = 400 баллов. Формула нормализации совпадает с выражением (11) модели при фиксированном значении максимума и эквивалентна выражению (15).
Применение модифицированного метода обусловлено спецификой задачи оценки рисков информационной безопасности. Во-первых, фиксированная верхняя граница Rmax = 400 баллов установлена экспертным путем на основе анализа максимально возможного ущерба для типовых информационных систем и обеспечивает стабильность шкалы при повторных аудитах: результаты оценки рисков, проведенной в разные периоды времени, остаются сопоставимыми, что критично для мониторинга динамики защищенности ИС. Во-вторых, функция обрезания min(Ri,Rmax) исключает влияние экстремальных значений на итоговую нормализацию. В классическом методе появление единственной угрозы с аномально высоким риском привело бы к «сжатию» шкалы для всех остальных угроз, что исказило бы их взаимное ранжирование. В разработанной методике такие значения просто достигают потолка в 100 %, не влияя на распределение остальных рисков. В-третьих, модифицированный метод обладает вычислительной устойчивостью: поскольку алгоритм детерминирован и не содержит итерационных процедур, погрешность вычислений ограничена машинным эпсилоном ε ≈ 2,22·10–16 для 64-битных чисел с плавающей запятой и не накапливается при обработке 155 угроз, нулевое отклонение за 1000 прогонов показывает детерминированность (табл. 3). Функция нормализации является липшицевой с константой L = 100/400 = 0,25, что подтверждено экспериментом с экстремальными значениями (табл. 5) и гарантирует отсутствие лавинообразного роста ошибок. Таким образом, модификация метода Min-Max позволяет сохранить простоту и интерпретируемость классического подхода, одновременно обеспечивая требования нормативного риск-менеджмента: воспроизводимость, сопоставимость результатов во времени и устойчивость к экстремальным значениям.
Калибровка экспертных коэффициентов и проверка модели
Все коэффициенты модели являются экспертно-расчетными, поскольку Банк данных угроз ФСТЭК России содержит идентификаторы угроз, объекты воздействия и их описания, но не содержит количественных значений вероятностей реализации угроз. В связи с этим значения коэффициентов получены методом экспертных оценок.
В состав экспертной группы вошли три специалиста подразделения информационной безопасности Оренбургского государственного университета имени В. А. Бондаренко. Исходную выборку составили: Банк данных угроз безопасности информации ФСТЭК России по состоянию на 10.02.2026, содержащий 227 угроз; перечень из 155 угроз, отобранных после фильтрации по критерию отсутствия в ИС суперкомпьютерных, облачных и ИИ-компонентов; перечень из 12 типов активов информационной системы образовательной организации; перечень из 18 мер защиты, используемых в анкете программного средства; характеристики информационной системы образовательной организации, полученные в ходе апробации методики.
Для калибровки коэффициентов сформирована выборка из 48 синтетических модельных профилей информационных систем образовательных организаций, различающихся составом активов, масштабом организации, масштабом информационной системы, оценками возможного ущерба и статусами реализации мер защиты. Из 48 профилей 36 использованы для калибровки коэффициентов, 12 – для отложенной проверки модели. Экспертное оценивание проводилось в два тура по методу Дельфи: на первом туре эксперты независимо задавали значения коэффициентов и ранжировали угрозы по уровню риска для каждого профиля; на втором туре проводилось согласование оценок, расхождение по которым превышало установленный порог. Согласованность экспертных оценок оценивалась коэффициентом конкордации Кендалла, значения которого составили не менее 0,74 для групп коэффициентов, что свидетельствует о достаточной согласованности.
В качестве критерия оптимизации использовалось минимальное среднее абсолютное отклонение модельных нормализованных рисков от экспертных оценок риска при дополнительном ограничении на согласованность ранжирования топ-10 угроз. Подбор значений выполнялся методом координатного поиска в заранее заданных допустимых диапазонах коэффициентов.
Формально задача калибровки записывается как задача параметрической оптимизации. Пусть θ = (θ1,…,θq) – вектор калибруемых коэффициентов (P0i, γ0отр, Kотрia, φi,k, ψim, Rmax); Pcal – множество калибровочных профилей (|Pcal| = 36); Ep,i – экспертная оценка нормализованного риска i-й угрозы для профиля p; Rp,i%(θ) – соответствующее значение, вычисленное по модели (11). Критерий оптимизации имеет вид
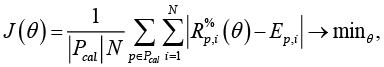 (19)
при ограничениях
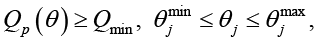 (20)
где Qp(θ) – показатель согласованности ранжирования топ-10 угроз по модели и по экспертной оценке для профиля p, Qmin – допустимый порог, [θjmin, θjmax] – заранее заданный допустимый диапазон j-го коэффициента.
Таблица 6
Этапы методики и используемые выражения модели и метода
|
Этап |
Содержание действий |
Выражения модели и процедуры метода |
Результат |
|
Подготовка (однократно) |
Формирование базы угроз (фильтрация Банка данных угроз ФСТЭК: 227 → 155 угроз); экспертное задание и калибровка коэффициентов (метод Дельфи, два тура); проверка модели на отложенных профилях; анализ чувствительности |
Диапазоны коэффициентов – (5)–(7); калибровка – (19), (20); анализ чувствительности – (16)–(18) |
Реляционная база данных угроз, коэффициентов и рекомендаций |
|
1. Выбор типа организации |
Пользователь выбирает одну из восьми сфер деятельности; из базы данных загружаются отраслевые коэффициенты частоты и ущерба |
Коэффициенты γ0отр, Kотрia – (6), (7) |
Отраслевые коэффициенты выбранного типа организации |
|
2. Сбор характеристик ИС |
Заполнение анкеты: состав активов и их ценность; масштаб организации (численность персонала, филиальная сеть); оценка ущерба по свойствам ИБ и масштаб ИС с автоматическим определением класса защищенности К1–К3 [2]; статусы реализации 18 мер защиты и классы СЗИ |
Множество активов и ценности – (1), (2); коэффициенты α, β; ответы xk, xm – в (8), (9) |
Характеристика ИС; класс защищенности; требуемые классы СЗИ |
|
3. Идентификация актуальных угроз |
Формирование множества угроз из базы данных ФСТЭК (N = 155), определение для каждой угрозы затрагиваемых активов и базовой вероятности |
Множество угроз и подмножества активов – (3), (4); базовая вероятность – (5) |
Перечень актуальных угроз с привязкой к активам |
|
4. Количественная оценка рисков |
Для каждой угрозы последовательно рассчитываются ущерб, вероятность, риск и нормализованный риск; вычисляется общий риск ИС |
Ущерб (метод взвешенных сумм) – (8); вероятность – (9); риск – (10); нормализация при Rmax = 400 – (11), (15); общий риск – (12) |
Ri, Ri%, Rtotal |
|
5. Ранжирование угроз |
Упорядочение угроз по убыванию нормализованного риска, выделение 10 наиболее критичных угроз |
Ранжирование – (13) |
Ранжированный перечень угроз, T10 |
|
6. Формирование рекомендаций |
Сопоставление требуемых и реализованных мер защиты и классов СЗИ; формирование рекомендаций трех уровней приоритета (критические, важные, информационные) и общих рекомендаций по инфраструктуре; экспорт отчета в форматах Word и Excel |
Правила проверки класса защищенности и сертификации СЗИ [2]; результаты этапов 4 и 5 |
Отчет с рекомендациями по снижению рисков |
Примечание: составлена авторами на основе полученных данных в ходе исследования.
Координатный поиск реализуется следующим образом: на каждой итерации выбирается один коэффициент θj, его значение перебирается в допустимом диапазоне при фиксированных остальных коэффициентах, принимается значение, дающее наименьшее J(θ) при выполнении ограничения (20), после чего выполняется переход к следующему коэффициенту. Процедура повторяется по всем коэффициентам до прекращения улучшения целевой функции. Отложенные 12 профилей в подборе коэффициентов не использовались и применялись только для проверки модели.
Методика автоматизированного анализа рисков информационной безопасности
На основе математической модели (1)–(12) и вычислительного метода (13)–(20) сформулирована методика автоматизированного анализа рисков ИБ – система правил, определяющая порядок действий пользователя и программного комплекса. Методика включает подготовительный этап, выполняемый однократно при создании и актуализации базы данных, и шесть этапов применения, выполняемых при каждой оценке рисков. Для каждого этапа в табл. 6 указаны используемые выражения модели и процедуры вычислительного метода.
Таким образом, методика определяет порядок применения модели и вычислительного метода, а программный комплекс, описанный в разделе «Результаты исследования и их обсуждение», автоматизирует выполнение этапов 1–6.
Результаты исследования и их обсуждение
Алгоритм работы программного средства реализует циклический процесс сбора характеристик ИС, валидации введенных данных, вычисления рисков и визуализации результатов. Пользователь последовательно заполняет три логических блока анкеты: «Общие вопросы» (численность персонала, филиальная сеть, типы защищаемых активов), «Класс защищенности» (оценка ущерба по трем свойствам ИБ, масштаб ИС, автоматическое определение класса К1–К3) и «Вопросы по ИС организации» (статус реализации 18 мер защиты, классы СЗИ), расчет и ранжирование рисков по каждой угрозе, формирование рекомендаций по снижению их уровня. Калибровка параметров модели проводилась итерационным методом. Использовались различные входные данные и проводилось сравнение, выявление расхождений, корректировка модели, чтобы ее выходы максимально точно совпадали с реальными, наблюдаемыми данными. Для оценки чувствительности модели использовался метод «одного изменения», изменяли один параметр и проверяли, как меняется результат, что позволило оценить влияние каждого параметра, определена средняя чувствительность. Окно программы «Результаты оценки рисков информационной безопасности» показано на рисунке.
Программная реализация модели, вычислительного метода и методики выполнена на языке Python 3.8. Архитектура приложения включает модуль графического интерфейса (PyQt6), реляционную базу данных угроз и отраслевых коэффициентов (sqlite3), подсистему динамической визуализации соответствия (BeautifulSoup4), а также модули экспорта отчетности (openpyxl, python-docx). Для обеспечения воспроизводимости исследований реализованы механизмы сохранения и загрузки характеристик организаций в формате JSON.
Для оценки экономической эффективности внедрения методики проведен сравнительный анализ трудоемкости ручного и автоматизированного процессов оценки рисков. Данные получены на основе экспертного опроса специалистов по ИБ и хронометража типовых операций для одной информационной системы на базе Оренбургского государственного университета имени В. А. Бондаренко (табл. 7).
Пояснения к терминам табл. 7. Хронометраж проведен на основе пяти независимых замеров для каждой операции с участием трех специалистов отдела ИБ. Под «разбросом» понимается максимальное процентное отклонение от среднего значения (диапазон вариации), обусловленное субъективностью экспертных оценок при ручном расчете. «Среднее число итераций согласования» отражает необходимость двух-трех повторных вычислений при ручном методе для исправления арифметических и логических ошибок, тогда как автоматизированный алгоритм выполняет расчет детерминированно за один проход. Часовая тарифная ставка (ЧТС) специалиста принята на уровне 600 руб./час на основе анализа средних рыночных показателей для аналитиков ИБ в регионе (данные агрегаторов вакансий за 2025–2026 гг.). Суммарные трудозатраты снижаются с 46 до 1,3 человеко-часов.
Наибольший разброс при ручном методе (до ±60 % на этапе расчета ущерба) обусловлен субъективностью экспертных оценок и сложностью работы по оценке ценности информационных активов. Разброс при автоматизации стремится к нулю (±0 % на математических этапах), так как программа использует жестко заданные коэффициенты.
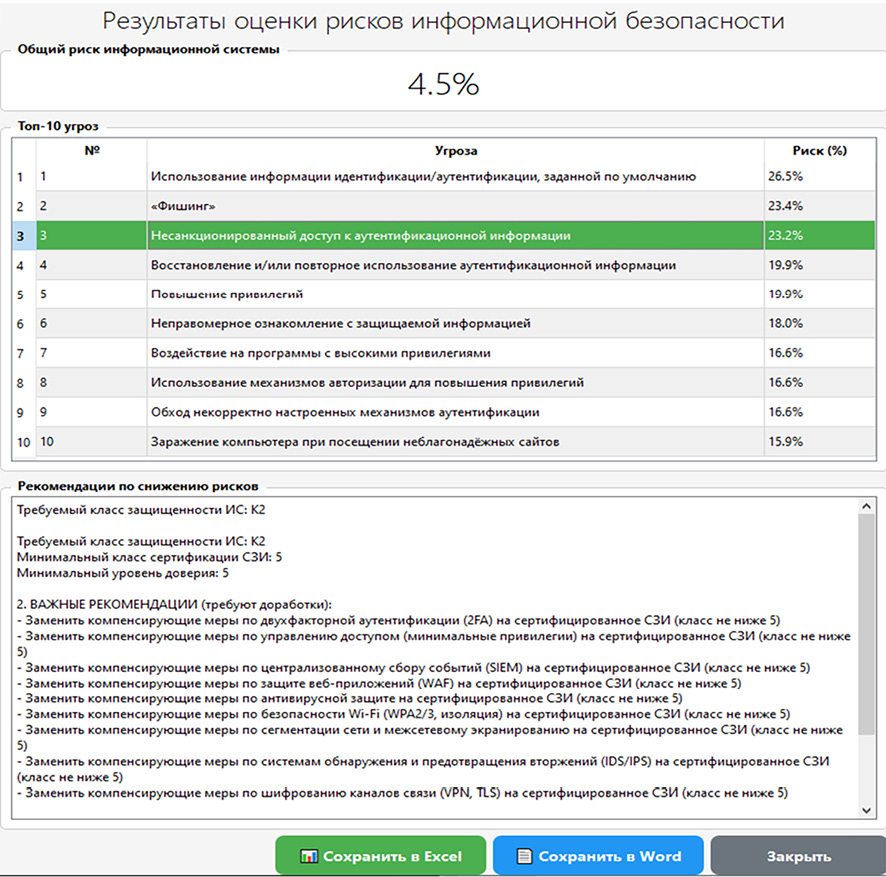
Окно программы «Результаты оценки рисков информационной безопасности» Примечание: составлен авторами по результатам данного исследования
Таблица 7
Сравнительная характеристика трудозатрат
|
Вид работы |
Исполнители |
Среднее число итераций согласования |
Ручной расчет: ср. время (ч) / разброс |
Автоматизация: ср. время (ч) / разброс |
|
Сбор и ввод исходных данных для ИС |
Аналитик ИБ, владелец ИС |
2 |
8,0 / ±40 % |
0,5 / ±10 % |
|
Идентификация и актуализация угроз |
Аналитик ИБ |
2 |
4,0 / ±30 % |
0,2 / ±5 % |
|
Оценка существующих мер защиты |
Аналитик ИБ |
2 |
10,0 / ±50 % |
0,2 / ±10 % |
|
Расчет ущерба для каждой угрозы |
Аналитик ИБ |
3 |
8,0 / ±60 % |
0,1 / ±0 % |
|
Расчет вероятности реализации каждой угрозы |
Аналитик ИБ |
3 |
4,0 / ±50 % |
0,1 / ±0 % |
|
Расчет риска |
Аналитик ИБ |
2 |
2,0 / ±40 % |
0,1 / ±0 % |
|
Формирование отчета и рекомендаций |
Аналитик ИБ |
2 |
10,0 / ±30 % |
0,1 / ±5 % |
|
Итого |
46,0 |
1,3 |
Примечание: составлена авторами на основе полученных данных в ходе исследования.
Способ расчета экономии: расчет экономии проводится через сокращение трудозатрат. Базовая экономия за одну оценку рисков для одной ИС оценивается снижением трудоемкости выполнения операций, как разница трудозатрат до внедрения автоматизации процессов и после внедрения (Т1-Т2), умноженная на часовую тарифную ставку специалиста (ЧТС):
= (46 – 1.3) × 600 = 26820 р.
Необходимо учитывать, что работа по оценке рисков информационной безопасности в рамках своей организации проводится не реже одного раза в год, это зависит от многих факторов: отрасли и характера данных, сложности инфраструктуры, предыдущих инцидентов, требований регуляторов, бюджета.
Экспериментальная апробация методики в рамках данной работы проведена на базе информационной системы образовательной организации (Оренбургский государственный университет имени В. А. Бондаренко). Разработанная методика обладает потенциалом адаптируемости для предприятий различных отраслей: для этого достаточно актуализировать отраслевые коэффициенты (γ,α) в реляционной базе данных в соответствии со спецификой нового объекта защиты. Однако выводы о точности и производительности в настоящей статье базируются на результатах, полученных в ходе апробации в образовательном секторе. Апробация была ограничена одной образовательной организацией. Апробация методики проводилась на базе Оренбургского государственного университета, данные получены на основе экспертного опроса специалистов отдела информационной безопасности университета. Разработанная методика снижает ключевые недостатки традиционных подходов: субъективность качественных шкал компенсируется введением отраслевых и масштабирующих коэффициентов, а формализация нечетких правил обеспечивает детерминированность вывода при сохранении гибкости. Интеграция с актуальной базой угроз ФСТЭК и автоматическая проверка соответствия СЗИ нормативным классам повышают готовность организаций к аттестационным проверкам и аудитам соответствия.
Обоснование утверждений об объективности, точности и снижении влияния человеческого фактора базируется на следующих положениях, подтвержденных результатами экспериментов:
1. Детерминированность математической модели. В отличие от качественных методов, опирающихся на субъективные экспертные шкалы («высокий/средний/низкий»), разработанная методика использует формализованные числовые коэффициенты (γ, α, β, φ), значения которых зафиксированы в реляционной базе данных risks.db и не зависят от субъективных качеств аналитика. При одинаковых входных данных программа гарантированно выдает идентичный результат, что подтверждено численным экспериментом из 1000 последовательных прогонов для ИС ОГУ: максимальное отклонение по всем 155 угрозам составило 0,0 балла, ранжирование топ-10 не изменялось (табл. 3).
2. Воспроизводимость результатов. Сравнение ручного и автоматизированного расчетов (табл. 7) показало, что разброс значений при ручном методе достигает ±60 % на этапе оценки ущерба из-за субъективности экспертных оценок, тогда как при автоматизации разброс стремится к ±0 % на вычислительных этапах. Это обеспечивается применением модифицированного метода Min-Max нормализации в фиксированном диапазоне и метода взвешенных сумм (WSM) с жестко заданными весами.
3. Верификация соответствия нормативным требованиям. Алгоритм автоматической проверки класса защищенности ИС (К1, К2, К3) и класса сертификации СЗИ реализует требования Приказа ФСТЭК России № 117 от 11 апреля 2025 г. [2] в виде формальных логических правил, что снижает возможность ошибочной интерпретации нормативных документов аналитиком.
Практическая значимость работы заключается в том, что разработанная методика и программное средство могут рассматриваться как вспомогательный инструмент предварительной оценки рисков, апробированный на информационной системе образовательной организации и требующий дальнейшей экспертной проверки и актуализации нормативной базы. Архитектура программного комплекса предусматривает возможность его адаптации для организаций других отраслей за счет модульной структуры реляционной базы данных, в которой все используемые коэффициенты хранятся в виде настраиваемых параметров и могут быть актуализированы без модификации вычислительного ядра программы. В рамках апробации на базе Оренбургского государственного университета имени В. А. Бондаренко методика продемонстрировала свою работоспособность для задач оперативного риск-менеджмента, обоснования бюджетов на информационную безопасность и формирования технических заданий на проектирование систем защиты. Перспективы дальнейших исследований связаны с расширением эмпирической базы за счет проведения независимых кейсов в организациях иных отраслей, расширением базы угроз за счет интеграции с национальными центрами мониторинга кибербезопасности, внедрением предиктивных моделей оценки рисков на основе анализа сетевого трафика и адаптацией методики для оценки безопасности объектов критической информационной инфраструктуры.
Заключение
В рамках исследования разработаны и экспериментально проверены математическая модель процесса оценки рисков информационной безопасности, вычислительный метод ее реализации (нормализация и ранжирование рисков, калибровка коэффициентов, анализ чувствительности) и методика автоматизированного анализа рисков и выбора мер их снижения. Экспериментальная апробация программного комплекса была проведена на базе информационной системы образовательной организации, что подтвердило работоспособность предложенных алгоритмов и корректность математической модели.
Несмотря на то, что текущие выводы ограничены результатами апробации в образовательном секторе, модульная архитектура разработанного решения и использование настраиваемых отраслевых коэффициентов создают потенциал для его адаптации и применения в организациях других отраслей при соответствующей актуализации нормативной базы. Предложенный подход, сочетающий детерминированные вычисления с автоматизированными нормативными проверками, позволяет снизить субъективность качественных оценок, минимизировать влияние человеческого фактора и обеспечить высокую воспроизводимость результатов в строгом соответствии с требованиями регуляторов Российской Федерации.
[1] ENISA Threat Landscape 2025: Annual report on the state of cybersecurity threats / European Union Agency for Cybersecurity (ENISA). Athens, Greece, October 2025. 142 p. [Электронный ресурс]. URL: https://www.enisa.europa.eu/publications/enisa-threat-landscape-2025 (дата обращения: 15.07.2026).
Conflict of Interest
Funding
Bibliographic Reference
URL: https://top-technologies.ru/en/article/view?id=40963 (accessed: 10/11/2026).
DOI: https://doi.org/10.17513/snt.40963