METHOD FOR FACIAL EXPRESSION RECOGNITION IN REAL CONDITIONS BASED ON CONVNEXT AND VA MANIFOLD PROTOTYPE ALIGNMENT
Введение
Распознавание мимики (Facial Expression Recognition, FER) направлено на определение эмоционального состояния по статическим изображениям и широко применяется в таких областях, как взаимодействие человека с компьютером, интеллектуальные кабины и общественная безопасность. В полевых условиях различия в освещении, позе и затенении могут привести к перекрытию в пространстве признаков таких категорий, как «радость и презрение», «удивление и страх», «гнев и отвращение». AffectNet одновременно предоставляет восемь дискретных категорий выражений лица и непрерывные метки валентности-возбуждения (Valence–Arousal, VA) и является широко используемым обучающим набором данных исходного домена [1]; FER2013, RAF-DB, SFEW и другие наборы данных часто используются для межбазовой оценки [2–4]. Обобщение на другие наборы данных по-прежнему остается сложной задачей при внедрении: высокая точность в исходном домене не означает напрямую, что признаки являются переносимыми; необходимо одновременно анализировать результаты внутридоменного сравнения и результаты межбазового тестирования без тонкой настройки в рамках единого протокола. В конкурсе по анализу аффективного поведения в естественных условиях (Affective Behavior Analysis in-the-wild, ABAW) в качестве важного показателя для задач распознавания эмоций используется макро-F1 [5].
Что касается базовых моделей и многозадачности, то конволюционные архитектуры, такие как ConvNeXt, по-прежнему широко используются для классификации статических выражений лица [6]; модели типа POSTER демонстрируют высокую точность в рамках протокола AffectNet с восемью классами [7]. Сочетание дискретной классификации и VA-регрессии способствует улучшению инференции выражений лица [8, 9], а коэффициент конкордантной корреляции (Concordance Correlation Coefficient, CCC) также часто используется для VA-обучения [10]. Ограничения на прототипы классов позволяют смягчить проблему недостаточных межклассовых отношений при one-hot-обучении [11]. Однако классификационные потери, регрессия VA и межклассовые геометрические отношения по-прежнему часто обрабатываются отдельно. Обучающий набор AffectNet имеет выраженный «длинный хвост», а близкие классы пересекаются на плоскости VA [12–14]. Поэтому простое увеличение глубины сети зачастую не позволяет стабильно подавлять перекрестные помехи [15, 16].
Цель исследования – посредством внедрения механизма выравнивания прототипов VA-многообразий явно ограничить топологическую геометрию многообразий в высокомерном пространстве признаков, что позволит коренным образом исправить асимметрию границ принятия решений, связанную с эмоциями, которые легко спутать с эмоциями ближайших соседей.
Материалы и методы исследования
Входными данными модели являются трехканальные цветные изображения лиц (red, green, blue, RGB) размером 224×224. Сеть состоит из базовой архитектуры ConvNeXt-Small [17], слоя общей проекции d = 512 и многозадачной выходной головки. Структура многозадачной сети распознавания эмоций на основе ConvNeXt и модуля VMPA (VA-Manifold Prototype Alignment) представлена на рис. 1.
Пусть обучающая выборка имеет вид (xi, yi, vi, mi), i = 1,…,N, где xi обозначает входное изображение, yi ∈ {0,…,C–1} – целевой класс эмоции, C = 8 – количество категорий эмоций, 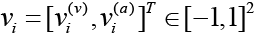 – разметку валентности и активации (VA), а
 представляет собой маску валидности VA. Обозначим набор валидных VA-выборок как
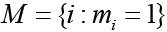 . Суммарная функция потерь записывается так, как показано в уравнении
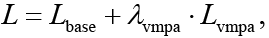
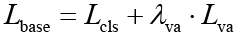 , (1)
где L – суммарная функция потерь; Lbase – базовые многозадачные потери; Lvmpa – регуляризационный член VMPA; Lcls – потери классификации; Lva – потери регрессии VA (вычисляемые только для i ∈ M); λvmpa, λva – соответствующие весовые коэффициенты.
Прямое отображение сети записывается так, как показано в уравнении
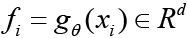 , (2)
где fi – вектор общих (разделяемых) признаков; gθ – функция отображения, включающая магистральную сеть (backbone) ConvNeXt и общий проекционный слой; θ – параметры сети. d = 512. Прямой проход классификационной головы записывается так, как показано в уравнении
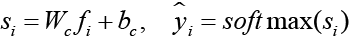 , (3)
где si – логиты классификации; Wc, bc – параметры классификационной головы; ŷi – вектор вероятностей категорий.
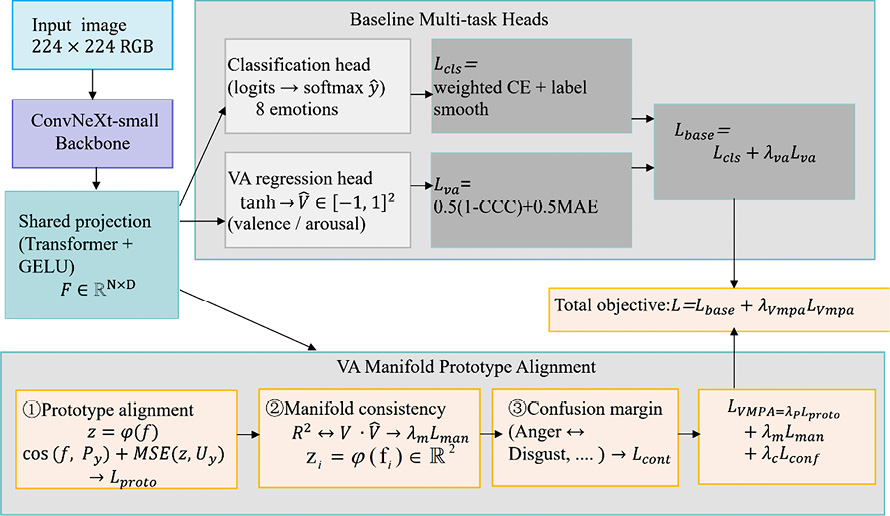
Рис. 1. Многозадачная сеть распознавания эмоций на основе ConvNeXt и структура модуля VMPA Примечание: составлен авторами по результатам данного исследования
Прямой проход головы регрессии VA записывается так, как показано в уравнении
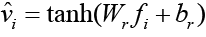 , (4)
где  – выход регрессии VA; Wr, br – параметры головы регрессии; tanh – гиперболический тангенс, ограничивающий выходные значения диапазоном [–1,1]2. При обучении перед классификационной головой и головой VA применяется слой Dropout с вероятностью p = 0.5.
В качестве функции потерь классификации используется взвешенная перекрестная энтропия со сглаживанием меток (Label Smoothing). Сглаживание целевых меток записывается так, как показано в уравнении
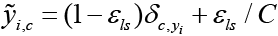 , (5)
где εls = 0.1 – коэффициент сглаживания меток (фактор сглаживания);  – символ Кронекера; w_c – весовые коэффициенты классов, используемые для смягчения проблемы длинного хвоста в наборе данных AffectNet [1]. Потери классификации записываются так, как показано в уравнении
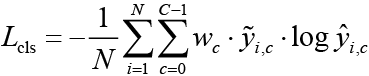 , (6)
где N – количество выборки (число образцов); ỹi,c – сглаженная целевая метка; ŷi,c – прогнозируемая вероятность. Потери регрессии VA вычисляются только для выборки i ∈ M. Потери регрессии VA вычисляются только для образцов с валидными VA-аннотациями. Для оценки согласованности между предсказанными и истинными значениями Valence–Arousal используется коэффициент согласованной корреляции Конкорданса (Concordance Correlation Coefficient, CCC). Коэффициент CCC вычисляется отдельно для каждого измерения VA. Для одного измерения он определяется следующим образом, как показано в уравнении
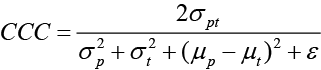 , (7)
где up, ut – средние значения предсказанных и истинных значений соответственно; σp2, σt2 – дисперсии; σpt – ковариация между предсказанными и истинными значениями; ε – малый член числовой стабильности. Для каждого валидного mini-batch коэффициент CCC сначала вычисляется отдельно для измерений Valence и Arousal. Потери CCC определяются как среднее значение величин 1 – CCC по двум измерениям. Дополнительно вычисляется средняя абсолютная ошибка между предсказанными и истинными VA-значениями. Итоговые потери регрессии VA записываются следующим образом, как показано в уравнении
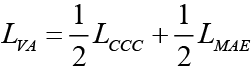 , (8)
где LCCC – компонент потерь, основанный на коэффициенте согласованной корреляции, усредненный по измерениям Valence и Arousal; LMAE – средняя абсолютная ошибка между предсказанными и истинными VA-значениями. Если в текущем mini-batch имеется менее двух валидных VA-образцов, компонент LCCC не вычисляется и используются только потери LMAE. Образцы без валидных VA-аннотаций не участвуют в вычислении VA-потерь. Базовые многозадачные потери записываются так, как показано в уравнении (9), λva = 3.5:
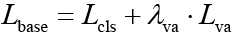 . (9)
Метод VMPA внедряет в разделяемые признаки выравнивание прототипов между признаковым и двойным VA-пространствами, многообразное проецирование и консистентность (согласованность) с головой регрессии VA, а также интервальное разделение для легко смешиваемых (близких) пар классов. Проектор многообразия φ представляет собой двухслойный перцептрон с выходом tanh, как показано в уравнении
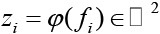 , (10)
где zi – координаты проекции многообразия; φ – проектор многообразия. Переменные zi и  образуют два пути передачи VA: первый поступает из проектора VMPA, а второй – из головы регрессии; они взаимно ограничивают друг друга посредством функции потерь Lman. Далее по тексту выражение MSE(∙,∙) обозначает среднее арифметическое квадратичных ошибок по каждому измерению. В результате для каждого входного образца формируются двумерные координаты zi на VA-многообразии, которые далее используются в механизмах прототипного выравнивания и согласования VA-многообразия.
Для каждого эмоционального класса c в модели вводятся два типа прототипов: обучаемый прототип признаков pc в общем пространстве признаков размерности 512 и обучаемый VA-прототип uc в двумерном пространстве Valence–Arousal.
Прототипы признаков pc инициализируются независимыми значениями из нормального распределения со стандартным отклонением 0,02. VA-прототипы uc инициализируются предварительно заданными приближенными координатами (валентность, активация) для классов Neutral, Happy, Sad, Surprise, Fear, Disgust, Anger, Contempt: (0; 0), (0,8; 0,5), (-0,6; -0,3), (0,3; 0,7), (-0,5; 0,6), (-0,7; 0,2), (-0,6; 0,5), (-0,2; 0,1). В процессе обучения оба типа прототипов являются обучаемыми параметрами модели и обновляются совместно с параметрами основной сети методом AdamW и обратным распространением ошибки.
Для каждого образца выполняется выравнивание его признакового представления с прототипом соответствующего класса в пространстве признаков, а координат на VA-многообразии – с соответствующим VA-прототипом, как показано в уравнении
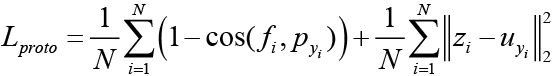 , (11)
где fi – общее признаковое представление i-го образца; zi – координаты образца после проекции на VA-многообразие; yi – истинная метка класса; pyi – прототип признаков соответствующего класса; uyi – соответствующий VA-прототип. Первый компонент обеспечивает сближение признаков образца с прототипом его класса на основе косинусного сходства, а второй компонент минимизирует среднеквадратичное отклонение между координатами VA-многообразия и соответствующим VA-прототипом.
Для обеспечения согласованности между VA-проекцией VMPA, истинными VA-аннотациями и выходом независимой головы регрессии вводятся потери согласования VA-многообразия. Данный компонент вычисляется только для образцов с валидными VA-аннотациями. Проекция VA-многообразия одновременно приближается к истинным VA-значениям и согласуется с выходом головы VA-регрессии, как показано в уравнении
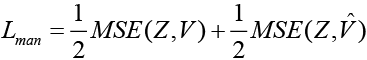 , (12)
где Z – матрица координат VA-многообразия для образцов с валидными VA-аннотациями; V – матрица соответствующих истинных значений Valence–Arousal;  – матрица значений, предсказанных головой VA-регрессии. В настоящей реализации оба компонента имеют одинаковый вес 0,5.
На основе высокочастотных ошибок в матрице ошибок на валидационном наборе заранее определяется множество из пяти неупорядоченных пар легко смешиваемых эмоциональных классов: Anger–Disgust, Neutral–Contempt, Fear–Surprise, Happy–Contempt и Neutral–Sad. Для реализации направленного маржинального ограничения каждая пара рассматривается в двух направлениях. Таким образом, в функции потерь используются 5 неупорядоченных пар, соответствующих 10 направленным отношениям между классами.
Для текущего мини-батча (mini-batch) обозначим
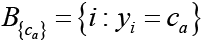 ,
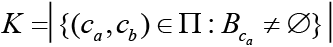 ,
где K – количество пар легко смешиваемых классов в текущем пакете, для которых якорный класс не пуст.
Для каждого образца, принадлежащего якорному классу a, вычисляется расстояние до прототипа собственного класса pa и до прототипа соответствующего легко смешиваемого класса pb. Маржинальное ограничение обеспечивает, чтобы образец располагался ближе к прототипу своего класса, чем к прототипу конкурирующего класса, с заданным запасом m = 0.2, как показано в уравнении
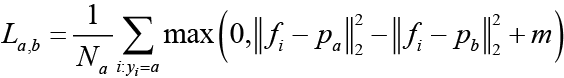 , (13)
где fi – признаковое представление i-го образца, принадлежащего якорному классу a; pa – прототип признаков собственного класса; pb – прототип признаков соответствующего легко смешиваемого класса; Na – количество образцов класса a в текущем mini-batch; m = 0.2 – величина маржи. Пакетное усреднение интервальных потерь для легко смешиваемых классов записывается так, как показано в уравнении
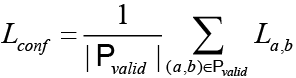 , (14)
где  – множество направленных пар легко смешиваемых классов, для которых в текущем mini-batch присутствует хотя бы один образец якорного класса;
 – количество таких направленных пар. Если множество
 пусто, значение Lconf принимается равным нулю. Три описанных компонента объединяются в единую функцию потерь модуля VA-Manifold Prototype Alignment, как показано в уравнении
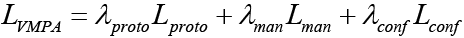 , (15)
где λproto = 1.0, λman = 1.0, λconf = 0.6 – внутренние весовые коэффициенты компонентов прототипного выравнивания, согласования VA-многообразия и маржинального разделения легко смешиваемых классов соответственно; в общей целевой функции потерь вес λVMPA = 0.4.
Результаты исследования и их обсуждение
Для основных экспериментов использовался поднабор AffectNet с ручной разметкой. В обучающей выборке количество образцов с метками эмоций от 0 до 7 составляет 287 652 изображения, при этом распределение классов имеет ярко выраженный длинный хвост. Значения валентности и активации лежат в диапазоне [–1;1]; образцы с невалидной разметкой отсекались с помощью маскирования при расчете потерь, связанных с VA. Официальный сбалансированный валидационный набор данных по восьми классам использовался в качестве основного оценочного набора.
Кросс-датасетное тестирование проводилось на тестовом наборе FER2013, содержащем 7178 изображений, валидационном наборе SFEW 2.0 и тестовом наборе RAF-DB, содержащем 3068 изображений. Исходные метки всех трех наборов данных проецировались на 8-классовое пространство эмоций AffectNet.
Официальный валидационный раздел SFEW 2.0 содержит 436 изображений. В эксперименте использовались файлы, фактически находящиеся в каталогах соответствующих эмоций. Критерием включения являлось наличие файла и возможность его успешного открытия как цветного изображения; дополнительная фильтрация с использованием детектора лиц не применялась. В результате были исключены 24 недоступных или нечитаемых файла, и в оценку вошло 412 изображений. Распределение по классам составило: Neutral – 82, Happy – 67, Sad – 68, Surprise – 50, Fear – 46, Disgust – 23, Anger – 76.
Во всех трех наборах отсутствуют истинные метки класса «Contempt». Вывод выполнялся с использованием исходной 8-классовой выходной головы, логит Contempt не исключался, а вероятности по семи классам не перенормировались. Accuracy рассчитывалась по всем образцам, а макрометрики усреднялись по восьми индексам классов. Для класса Contempt, отсутствующего в истинных метках, полнота (Recall) принималась равной нулю.
Размер входных изображений приводился к формату 224×224 с последующей нормализацией по среднему значению и дисперсии ImageNet. При обучении применялось случайное горизонтальное отражение, при тестировании случайная аугментация не использовалась.
Для оценки влияния масштаба данных на том же обучающем наборе AffectNet с использованием сбалансированной по классам выборки были сформированы три поднабора: Quick15 (15 %), Mid50 (50 %) и Full100 (100 %), для каждого из которых использовался один и тот же валидационный набор из 4000 образцов. В качестве магистральной сети (backbone) модели выступала предобученная на ImageNet сеть ConvNeXt-Small.
Сопоставление Baseline и VMPA выполнено при одинаковых гиперпараметрах в однократном обучении каждой конфигурации. Сводные точечные значения метрик (лучший checkpoint по macro-F1 на валидации AffectNet) приведены в табл. 1.
При переходе к полномасштабному обучению Full100 точность тестирования, достигнутая наилучшей моделью, дополнительно составила 65,35 %, демонстрируя, что масштабирование объема данных позволяет непрерывно раскрывать репрезентативный потенциал магистральной сети.
Вклад компонент Lproto, Lman, Lconf оценен абляцией на протоколе Full100; в табл. 2 приведены среднее и стандартное отклонение по пяти независимым запускам, Для каждой конфигурации выполнены пять независимых запусков с фиксированными seed 42, 123, 2026, 7 и 4. Остальные гиперпараметры не изменялись.
В таблице приведены среднее значение и стандартное отклонение по пяти независимым запускам (seed: 42, 123, 2026, 7, 4)
На рис. 2, a, представлена нормированная по строкам матрица ошибок для наилучшей модели VMPA в конфигурации Full100. Для систематической оценки обобщающей способности модели в различных кросс-доменных и сложных сценариях наилучшая модель VMPA, обученная на наборе Full100, была дополнительно протестирована на трех классических бенчмарках: FER2013, RAF-DB и SFEW.
На рис. 2 приведены нормированные по строкам матрицы ошибок для кросс-доменного тестирования.
Таблица 1
Сравнение Baseline и VMPA на валидации AffectNet
|
Доля обучающей выборки |
Метод |
macro-F1 (%) |
Accuracy (%) |
|
15 % (Quick15) |
Baseline |
53,17 |
52,91 |
|
VMPA |
52,43 |
52,72 |
|
|
50 % (Mid50) |
Baseline |
57,28 |
57,68 |
|
VMPA |
60,50 |
60,30 |
|
|
100 % (Full100) |
Baseline |
57,28 |
57,67 |
|
VMPA |
65,32 |
65,35 |
Примечание: составлена авторами на основе полученных данных в ходе исследования. Однократное обучение; checkpoint по лучшему macro-F1 на валидации AffectNet; точечные значения.
Таблица 2
Абляция компонентов VMPA
|
Конфигурация |
macro-F1( %) |
Accuracy (%) |
|
Baseline |
57,30 ± 0,22 |
57,69 ± 0,20 |
|
VMPA без Lproto |
62,43 ± 0,28 |
62,52 ± 0,26 |
|
VMPA без Lman |
64,28 ± 0,24 |
64,31 ± 0,22 |
|
VMPA без Lconf |
64,50 ± 0,23 |
64,36 ± 0,21 |
|
Полная VMPA |
65,28 ± 0,21 |
65,30 ± 0,19 |
Примечание: составлена авторами на основе полученных данных в ходе исследования.
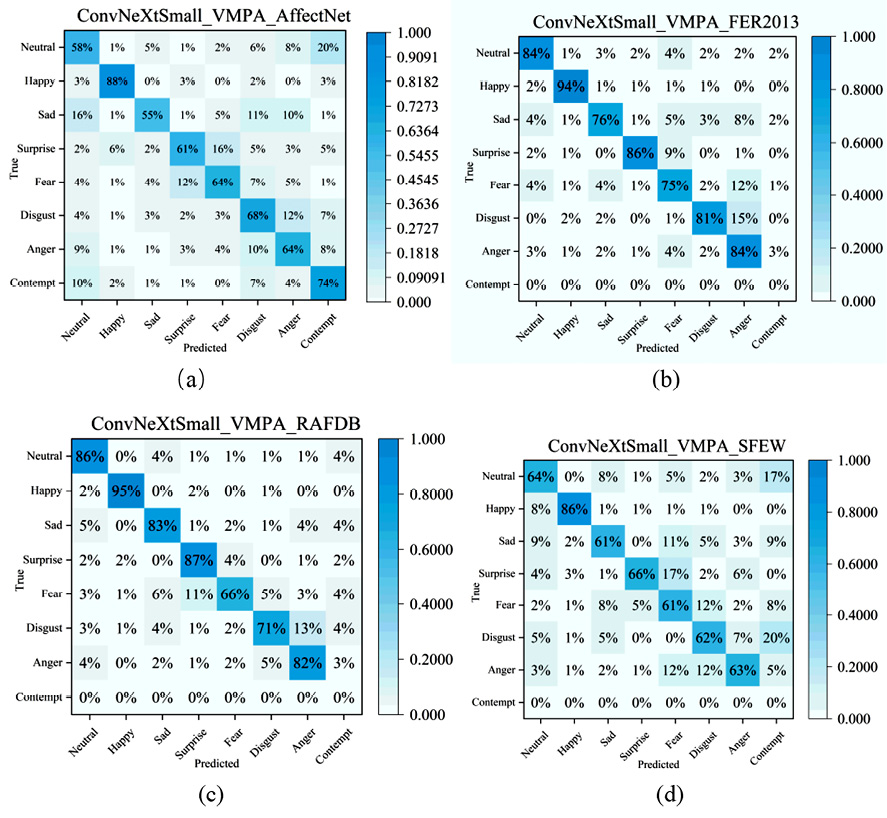
Рис. 2. Матрицы ошибок, нормированные по строкам, для различных наборов данных в конфигурации Full100 Примечание: составлен авторами по результатам данного исследования
Результаты экспериментов показывают, что, несмотря на существенные различия в распределении данных между исходным и целевым доменами, модель демонстрирует высокую помехоустойчивость и надежность распознавания во всех трех типичных сценариях.
Для сравнения эффективности модели на уровне отдельных классов в различных наборах данных на рис. 3 представлена лепестковая диаграмма для восьми классов эмоций, охватывающая датасеты AffectNet, FER2013, RAF-DB и SFEW. Оси координат соответствуют классам: Нейтральный, Радость, Грусть, Удивление, Страх, Отвращение, Гнев и Презрение. Значения на каждой оси представляют собой показатель полноты для соответствующего класса.
Чтобы подробнее раскрыть механизмы эволюции признаков и принятия решений внутри многозадачной модели, на рис. 4 показано двумерное пространственное распределение признаков наилучшей модели VMPA в режиме обучения Full100 на тестовой выборке. Путем сравнения топологических структур истинных меток в непрерывном пространстве эмоций (рис. 4, a) и предсказанных моделью значений (рис. 4, b) можно обнаружить, что голова регрессии предложенной модели способна с высокой точностью воспроизводить кольцевое геометрическое многообразие всего пространства эмоций. Как в правой области, характеризующейся высокими положительными значениями, так и в нижней отрицательной области пространство предсказаний сохраняет макроскопические границы и характеристики непрерывных переходов, которые в высокой степени согласуются с истинным распределением.
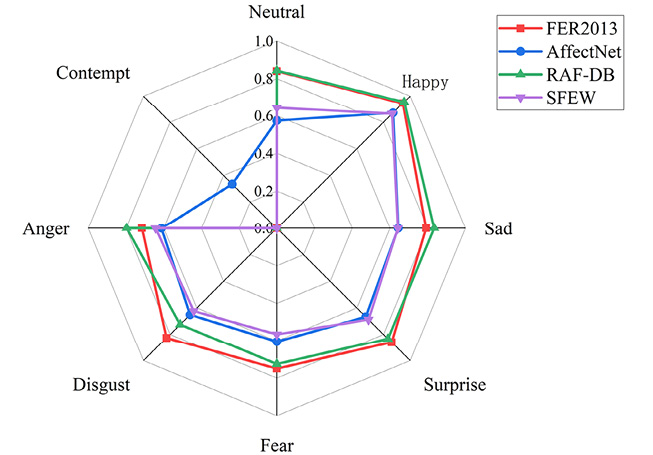
Рис. 3. Радарная диаграмма показателей по классам на AffectNet, FER2013, RAF-DB и SFEW Примечание: составлен авторами по результатам данного исследования
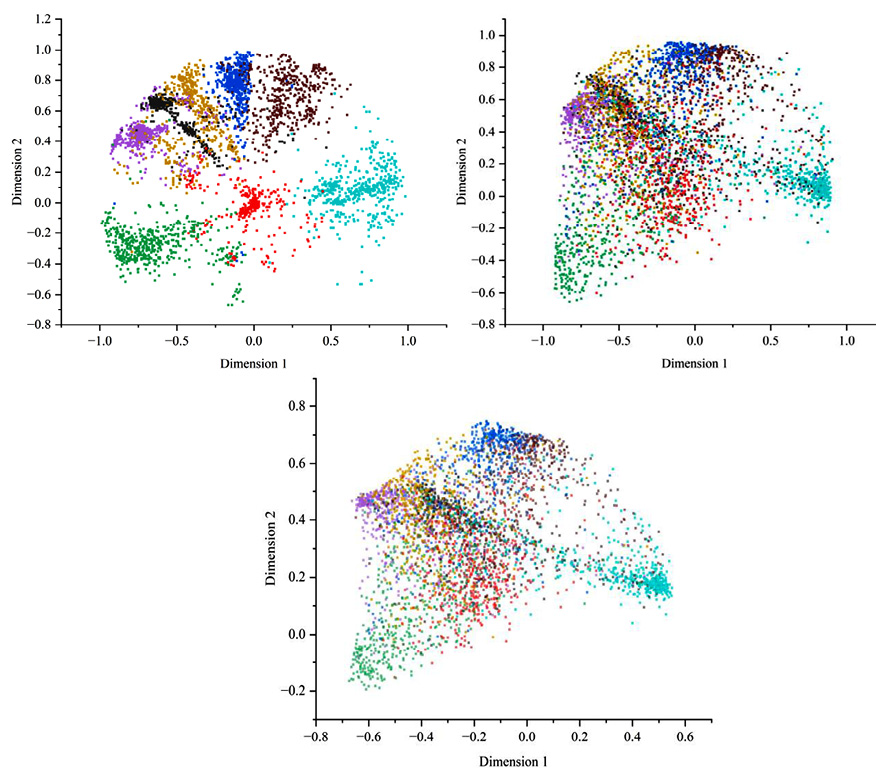
Рис. 4. Диаграмма рассеяния признаков: (a) истинные значения меток, (b) предсказанные моделью значения, (c) значения в скрытом пространстве многообразия Примечание: составлен авторами по результатам данного исследования
Это доказывает превосходную аппроксимирующую и обобщающую способность многозадачной архитектуры в задачах регрессии непрерывных эмоций.
Дальнейший анализ проекции пространства многообразия скрытых признаков (рис. 4, c) показывает, что бирюзовые точки в правой части образуют структуру в виде «изолированного полуострова» с высокой степенью физической обособленности и сильной центростремительностью. Это обеспечивает фундаментальную поддержку на уровне многообразия признаков для исключительно высокой точности классификации данной категории в матрице ошибок. Напротив, в левой верхней области точки желтого, фиолетового и коричневого цветов демонстрируют очевидное и масштабное физическое переплетение и взаимное перекрытие.
Данный факт точно объясняет внутренние причины взаимных ошибок классификации при распознавании отрицательных эмоций решающим классификатором. Описанный качественный анализ пространственного многообразия не только подтверждает необходимость введения геометрических ограничений, но и демонстрирует эффективность механизма синергетического многозадачного обобщения модели.
Заключение
Предложенная многозадачная модель на базе ConvNeXt-Small способна одновременно выполнять классификацию восьми категорий мимики и регрессию валентности-активации в едином общем пространстве признаков. Совместная оптимизация параметров ограничений для прототипов классов, проекций VA-многообразия и интервалов между легко смешиваемыми классами с помощью метода VMPA позволила повысить дискриминативную способность модели в условиях реального окружения. При полномасштабном обучении Full100 итоговая точность тестирования составила 65,00 %, при этом наилучшая модель достигла 65,35 %. В кросс-доменных тестах без дообучения сохранялась исходная 8-классовая голова: логит Contempt не исключался, вероятности по семи классам не перенормировались, макрометрики усреднялись по восьми индексам. На FER2013, RAF-DB и SFEW 2.0 Accuracy составила 82,86; 81,43 и 66,14 % соответственно. Для класса Contempt, отсутствующего в истинных метках, полнота принималась равной нулю. В рамках будущих исследований планируется адаптировать модель к сценариям с более сложной структурой данных и выраженным доменным сдвигом для дальнейшего повышения обобщающей способности в кросс-базовых задачах.
Conflict of Interest
Funding
Bibliographic Reference
URL: https://top-technologies.ru/en/article/view?id=40933 (accessed: 12/10/2026).