DEVELOPMENT OF A METHOD AND ALGORITHMS FOR ADAPTIVE FEDERATED LEARNING CONSIDERING DISTRIBUTED DELAYS IN CLIENT UPDATES
Введение
При иерархическом федеративном обучении (ФО) в интеллектуальных системах (ИС) параметры общей (глобальной, серверной) модели машинного обучения уточняются по результатам локальных вычислений на клиентских устройствах, передаваемым на глобальный сервер после промежуточного агрегирования на туманных узлах, без передачи исходных данных через глобальную (WAN) сеть [1, 2]. При асинхронном ФО за время формирования и доставки обновления параметры на сервере могут измениться вследствие применения других обновлений. Таким образом, результат окажется рассчитанным для прежней версии параметров общей модели.
Следовательно, при применении таких обновлений возможны колебания параметров и ухудшение качества обучения. В существующих решениях регулируются число локальных шагов [3], версионное устаревание [4] и доля клиентских результатов, допущенных к агрегированию [5]. В беспроводных сетях расписание передачи и веса агрегирования выбираются с учетом качества канала, представительности данных и возраста обновлений [6]. Однако ограничение версионного устаревания само по себе не определяет физический возраст обновлений. При неоднородности вычислительных и коммуникационных ресурсов клиентов [7] одинаковому числу смен версий может соответствовать разный полный возраст обновления – время от считывания исходных параметров до применения результата на сервере. При оценке запаздывания только по среднему возрасту утрачиваются сведения о разбросе задержек и доле сильно запоздавших обновлений. Даже при одинаковом среднем возрасте обновлений допустимые по условию локальной устойчивости значения шага обучения могут различаться. Поэтому при выборе шага необходимо учитывать распределение возраста обновлений.
Цель исследования – разработка и теоретико-экспериментальное обоснование метода и алгоритмов адаптивного федеративного обучения с учетом распределенного запаздывания клиентских обновлений.
Материалы и методы исследования
В настоящем исследовании рассматривается асинхронное ФО с обновлением параметров модели методом стохастического градиентного спуска [8, 9]. При анализе влияния запаздывания на динамику параметров предполагается, что структура модели на рассматриваемом интервале времени не изменяется. Пусть wk – вектор d параметров общей модели на глобальном сервере перед применением обновления k, F(w) – общая целевая функция, η > 0 – шаг обучения, fk – номер потока от туманного узла, gfk – стохастический градиент, sk – число изменений версии между считыванием параметров и применением:
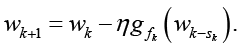 (1)
Введем локальную траекторию uk,e при выполнении E локальных шагов до передачи результата, начинающуюся из состояния общей модели wk–sk:
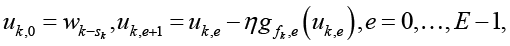 (2)
где gfk,e – стохастический градиент на e-м локальном шаге для потока fk. Результирующее обновление после E локальных шагов определяется как
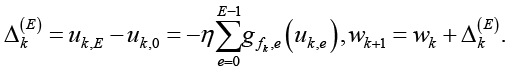 (3)
При E = 1 и 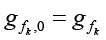 имеем
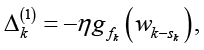 (4)
поэтому (3) сводится к одношаговой событийной модели (1). При E > 1 одно событие применения на глобальном сервере соответствует результирующему обновлению, сформированному последовательностью E локальных шагов.
Момент применения k-го обновления обозначим tk, его возраст – Ak; соответствующий момент считывания исходных параметров равен tk – Ak. События применения обновлений нумеруются в хронологическом порядке, поэтому 0 ≤ t0 < t1 <… . После применения каждого обновления версия параметров общей модели увеличивается на единицу. При Ak = 0 полагается, что считывание исходных параметров предшествует применению обновления. Для произвольного момента времени t число примененных обновлений n(t) и траектория параметров  определяются как
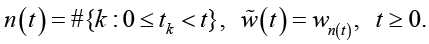 (5)
где # – число элементов. Для обновлений, сформированных до t = 0, траектория  при t < 0 задается так, чтобы
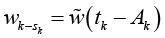 . Для начального состояния w0 и шума
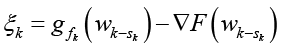
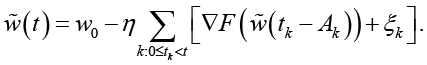 (6)
Для Nfog туманных узлов Nf – число обновлений, поступивших от f-го туманного узла и примененных на глобальном сервере за время наблюдения Tobs, а ρf = Nf / Tobs – интенсивность их применения, c–1. Через Kf(τ) обозначается неотрицательное ядро распределения возраста обновлений от f-го туманного узла, 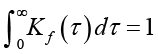 . При постоянных ρf, Kf и структуре модели остаток усреднения R(t) определяется равенством
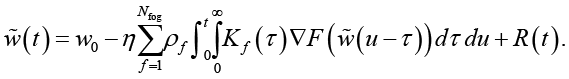 (7)
Здесь u – время интегрирования; в R(t) входят накопленный шум и ошибка замены событийной суммы интегралом. Для получения непрерывного детерминированного приближения принимается условие
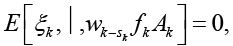 (8)
где E – математическое ожидание. Условие (8) означает, что в непрерывном приближении систематическое смещение среднего градиента отдельного потока относительно 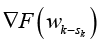 не учитывается. Поэтому модель применима к режимам, в которых такое смещение отсутствует либо пренебрежимо мало.
Пренебрегая R(t) и дифференцируя интегральное уравнение, получаем уравнение с распределенным запаздыванием для непрерывного детерминированного приближения w(t) с прежними начальным состоянием и предысторией:
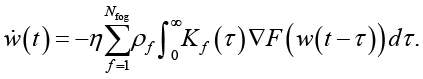 (9)
Для интервала длительности T положим 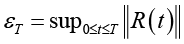 ,
 . При липшицевости градиента с константой L в области траекторий
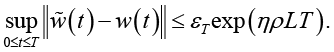 (10)
где ||∙|| – евклидова норма. При малом εT оценка (10) обеспечивает малость отклонения непрерывной траектории от событийной.
Для анализа локальной устойчивости в окрестности стационарного состояния w* введены возмущение x = w – w* и гессиан 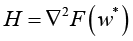 . Градиент целевой функции представлен в виде
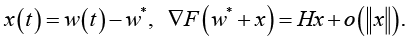 (11)
Остаток o(||x||) имеет более высокий порядок малости. Дальнейший анализ затухания проводится в собственных направлениях j гессиана H, для которых соответствующие собственные значения hj > 0. Для такого направления j, комплексного z и преобразования Лапласа 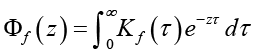
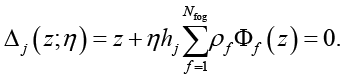 (12)
где Δj – характеристическая функция, α(η) – верхняя грань действительных частей ее корней по всем рассматриваемым направлениям j с hj > 0. При α(η) < 0 малые возмущения затухают локально во всех этих направлениях; ηcrit – шаг первой потери устойчивости.
Обновления  и
 соответствуют агрегированию соответственно после E локальных шагов и после каждого шага при одинаковых исходных параметрах, весах и мини-батчах:
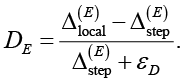 (13)
Деление на нуль исключается εD > 0. Для обратной связи фактическое DE вычисляется периодически: получают последовательным агрегированием после каждого локального шага на тех же мини-батчах. Такая проверка требует дополнительных градиентных вычислений и локального обмена между клиентами и туманным узлом, поэтому ее не следует выполнять в каждом цикле обновления.
Оценка расхождения  рассчитывается с исходными фиксированными гессианами, оценка дисперсии VD,E – по предшествующим мини-батчам при независимости градиентных шумов. Для построения расчетного одностороннего критерия используется поправка Чебышева – Кантелли
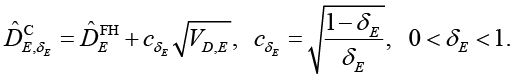 (14)
Величины  и VD,E не трактуются как точные математическое ожидание и дисперсия DE , поэтому (14) используется как оценочный критерий выбора числа локальных шагов, проверяемый по фактическим значениям DE . При предельном расхождении Dmax множество допустимых значений числа локальных шагов определяется как
εдоп 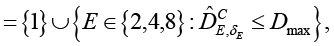 Esafe = max εдоп . (15)
При E = 1 обновления  и
 совпадают, поэтому D1 = 0 и множество εдоп не пусто. Число локальных шагов выбирается непосредственно из εдоп; величина Esafe обозначает его максимальное допустимое значение.
При классификации методами федеративного обучения необходимо учитывать неоднородность клиентских выборок и изменение их распределений [10]. Авторами в качестве классификатора исследуется инкрементальное дерево решений, позволяющее адаптировать структуру к поступающим данным без полного переобучения: расщепления выполняются по накопленной статистике [11, 12], а параметры листьев обновляются отдельно. При классификации с помощью дерева Te версии структуры e вероятность класса 1 в листе l равна
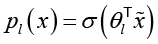 ,
где x – вектор признаков, θl – параметры листа, 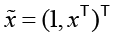 , T – транспонирование,
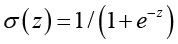 – логистическая функция. Для метки y ∈ {0,1} потеря Брайера ℓB и ее градиент:
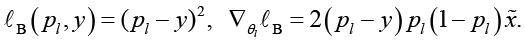 (16)
Для возраста обновления A порог Чебышева – Кантелли при среднем μA, стандартном отклонении σA < ∞ и риске превышения 0 < δA < 1 равен по аналогии с (14)
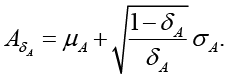 (17)
При использовании выборочных оценок  и
 , рассчитанных по предшествующим наблюдениям, значение (17) рассматривается как порог оценки. При изменении распределения возраста оценки моментов и порог пересчитываются. Допускаются обновления для текущей версии структуры e с возрастом
 . В буфере Be накапливаются счетчики классов для кандидатов Ce на расщепление. Для кандидата (j,t) используется уменьшение критерия Джини
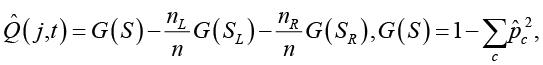 (18)
где S – наблюдения текущего листа, SL и SR – их части после расщепления, 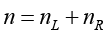 – число уникальных наблюдений текущего листа и текущей версии структуры, учтенных в объединенных клиентских счетчиках. Пусть
 и
 – два наибольших значения выигрыша среди рассматриваемых кандидатов. Для рассматриваемых бинарных задач классификации RQ = 1/2. Тогда
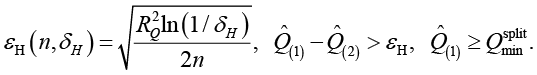 (19)
Граница Хеффдинга предполагает независимость наблюдений и стационарность ожидаемых выигрышей; повторное использование тех же наблюдений при обучении параметров листьев не увеличивает n.
При агрегировании клиентский результат задается кортежем Ui = (Ii, ei, vi, si, Wi, Gi), где Ii – идентификаторы клиентских результатов, ei, vi – версии структуры и параметров, si – идентификатор правил, Wi – вес, Gi = WiΔi. Совместимы результаты с общими e, v, s, непересекающимися Ii, положительными конечными весами и векторами одинаковой размерности. На туманном и серверном уровнях объединяются идентификаторы и суммируются веса и взвешенные обновления; Δagg = G / W [13]. Для исходных и текущих параметров
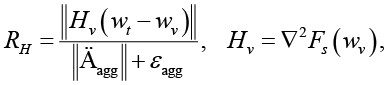 (20)
где Fs – целевая функция для конфигурации s.
При линеаризации 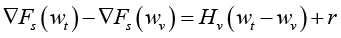 остаток r отдельно не ограничивается, поэтому условие ηRH ≤ δagg используется как эвристический локальный критерий, а не как строгая верхняя граница фактического рассогласования.
Экспериментальная проверка математического аппарата и разрабатываемых решений проведена на датасетах MNIST, ACSIncome, Electricity и Fed-Heart. Выполнены стендовые испытания и имитация взаимодействия клиентов и сетевых задержек в соответствии с архитектурой, представленной в статье [14]. Для результатов парных запусков дополнительно оценивались 95 %-ные доверительные интервалы (ДИ) парных различий методом процентильного бутстрепа по 20 000 ресэмплам.
Результаты исследования и их обсуждение
Для дискретных обновлений (1) с помощью временного представления (5) получено точное событийное равенство (6). После усреднения по времени и возрасту в (7) получено непрерывное приближение (9); его точность оценивается по (10).
В окрестности стационарного состояния w*, где 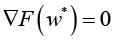 , после подстановки линеаризации (11) в (9) и отбрасывания остатка высшего порядка получено уравнение для малых отклонений параметров:
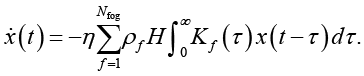 (21)
Для собственного вектора qj гессиана, Hqj = hjqj, и ненулевой комплексной амплитуды cj собственная мода уравнения (21) имеет вид
x(t) = qjcjezt. (22)
Подстановкой (22) в (21) получено характеристическое уравнение (12) для показателя z. При z = a + iω, где a – действительная часть корня, ω – угловая частота, i – мнимая единица, амплитуда пропорциональна eat. При a < 0 отклонение затухает, при a > 0 – растет; вещественные колебания получаются объединением комплексно-сопряженных мод.
Возможные критические значения шага находятся из условия наличия чисто мнимого характеристического корня:
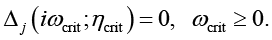 (23)
где ωcrit – угловая частота критической моды.
Значение из (23) принимается за ηcrit при первой смене знака α(η) с отрицательного на положительный. Характеристические корни вычислялись методом Ньютона по сетке начальных приближений в комплексной плоскости с допустимой невязкой 10–8. Полнота поиска правейшего корня контролировалась повторным расчетом в расширенной области по действительной и мнимой частям; результаты базового и расширенного поиска считались согласованными при различии правейших корней не более 2∙10–7. Область поиска расширялась до стабилизации наибольшей найденной действительной части. Дополнительно проверялись знак действительной части до и после ηcrit, сопряженность критической пары и отсутствие совпадения с полюсами.
Для проверки применимости полученной границы к дискретно-событийной динамике выполнено сравнение режимов обучения при значениях параметра шага ниже и выше ηcrit. Проверка проведена на модели TinyMLP – полносвязной нейронной сети с одним скрытым слоем, включающей 784 входа, 4 нейрона с функцией активации ReLU и 10 выходов (3190 параметров), – в однородном и неоднородном режимах поступления обновлений. В дискретно-событийной модели при η < ηcrit норма градиента затухала, а при η > ηcrit возрастала. Поэтому рассчитанная граница используется как ограничение параметра отдельного градиентного шага при фиксированной структуре модели.
Для расчета критических значений шага обучения ядра распределения возраста обновлений Kf(τ) представлены редуцированными распределениями [15]: в однородном (О) режиме – гамма-распределением с параметрами αf, θf в умеренном (У) и неоднородном (НО) – смесью двух распределений Эрланга
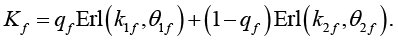 (24)
Интенсивности ρf и параметры редуцированных ядер приведены в табл. 1.
Таблица 1
Параметры редуцированных ядер распределения возраста
|
Режим |
f |
ρ1, с⁻¹ |
αf |
θf, с |
qf |
k1f |
θ1f, с |
k2f |
θ2f, с |
|
О |
1 |
16,7203 |
27,1775 |
0,00329088 |
– |
– |
– |
– |
– |
|
2 |
16,4068 |
36,8636 |
0,00223386 |
– |
– |
– |
– |
– |
|
|
3 |
17,0338 |
42,8303 |
0,00210190 |
– |
– |
– |
– |
– |
|
|
У |
1 |
16,6910 |
– |
– |
0,302141 |
237 |
0,000108763 |
75 |
0,000404280 |
|
2 |
16,6910 |
– |
– |
0,462479 |
173 |
0,000390460 |
18 |
0,00485575 |
|
|
3 |
16,6910 |
– |
– |
0,461915 |
103 |
0,000836365 |
21 |
0,00541527 |
|
|
НО |
1 |
28,6379 |
– |
– |
0,451599 |
256 |
0,0000400104 |
256 |
0,0000472330 |
|
2 |
14,3190 |
– |
– |
0,334707 |
118 |
0,000449937 |
21 |
0,00322166 |
|
|
3 |
6,8482 |
– |
– |
0,496937 |
84 |
0,00194216 |
10 |
0,0299423 |
Примечание: составлена авторами на основе полученных данных в ходе исследования.
Для H = diag(1,2,4) расчет по (12) с проверкой (23) выполнен в направлении наибольшей кривизны hmax = 4. Полученные критические значения шага ηcrit и соответствующие критические частоты ωcrit приведены в табл. 2.
Таблица 2
Критические значения шага обучения
|
Режим нагрузки |
Распределение возраста |
ηcrit |
ωcrit, с⁻¹ |
|
Однородный |
Гамма-распределение |
0,093206 |
18,0049 |
|
Умеренный |
Смесь двух распределений Эрланга |
0,160739 |
23,1209 |
|
Неоднородный |
Смесь двух распределений Эрланга |
1,083997 |
140,2014 |
Примечание: составлена авторами на основе полученных данных в ходе исследования.
Полученные результаты положены в основу метода (рис. 1), предназначенного для сокращения объема передачи данных через глобальную сеть при заданном качестве обучения и распределенном запаздывании клиентских обновлений. До локальных вычислений по предшествующим наблюдениям определяется порог возраста (17), а по распределению возраста, интенсивностям обновлений и локальной кривизне – ηcrit из (12) с проверкой (23), после чего выбирается η < ηcrit. Для выбранного шага по (14), (15) определяется множество εдоп, из которого в цикле m выбирается Em. В контрольных циклах вычисляется DEm по (13); при DEm > Dmax число локальных шагов последующих циклов уменьшается. При изменении распределения возраста или интенсивности обновлений границы пересчитываются.
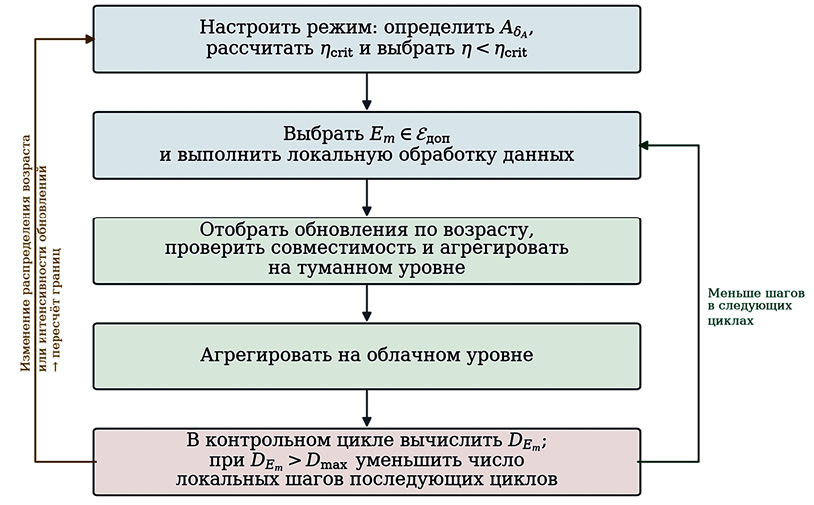
Рис. 1. Метод сокращения объема передачи данных через глобальную сеть в ИС на основе ФО Примечание: составлен авторами по результатам данного исследования
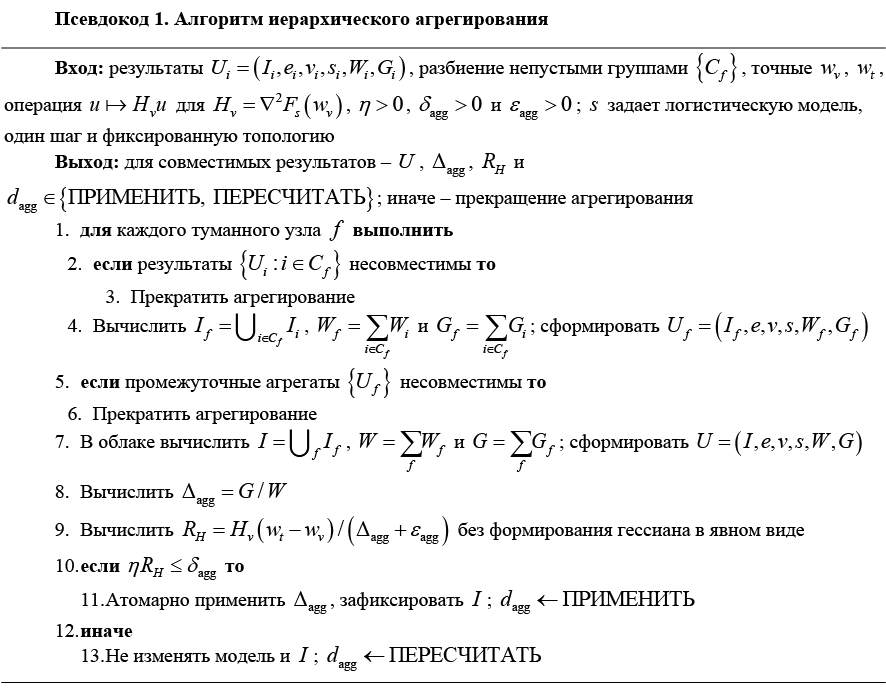
Также разработан алгоритм иерархического агрегирования (псевдокод 1): совместимые клиентские обновления объединяются через туманные узлы с проверкой версий структуры и параметров, правил вычисления и отсутствия повторных вкладов; итоговый агрегат определяется как Δagg = G / W. Для одношаговой логистической модели с бинарной перекрестной энтропией применимость агрегата оценивается по RH из (20): при ηRH ≤ δagg он применяется, иначе отклоняется, а новые обновления рассчитываются в следующем цикле по актуальным параметрам.
В качестве классификатора используется инкрементальное дерево решений с логистическими моделями в листьях (псевдокод 2). При фиксированной структуре параметры листьев обучаются по (16); к объединению допускаются результаты текущей версии структуры e с возрастом по (17), а счетчики классов накапливаются в буфере Be. Каждые  циклов при наличии не менее nmin наблюдений и двух кандидатов проверяется возможность расщепления: если для лучшего кандидата (j*,t*) выполнены условия (19), лист расщепляется, версия структуры увеличивается, а буфер прежней версии очищается; иначе накопление статистики продолжается. Условие η < ηcrit применяется только к параметрическим обновлениям при фиксированной структуре дерева. После структурного перехода ранее рассчитанная граница на новую структуру не переносится и определяется заново для нового состояния модели.
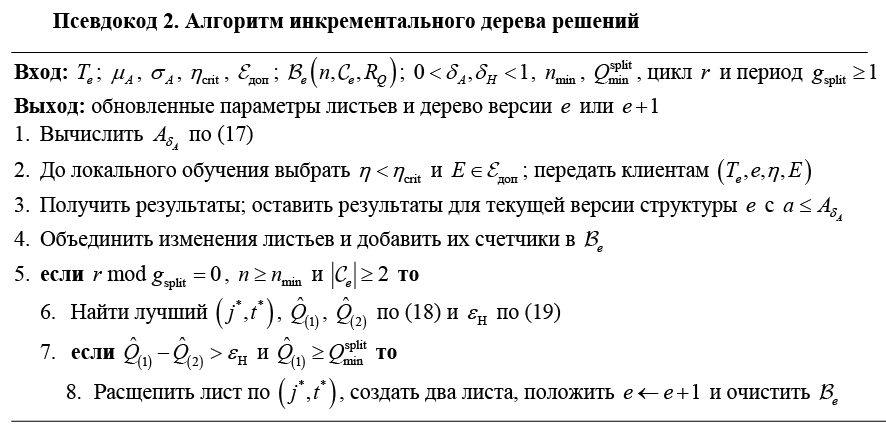
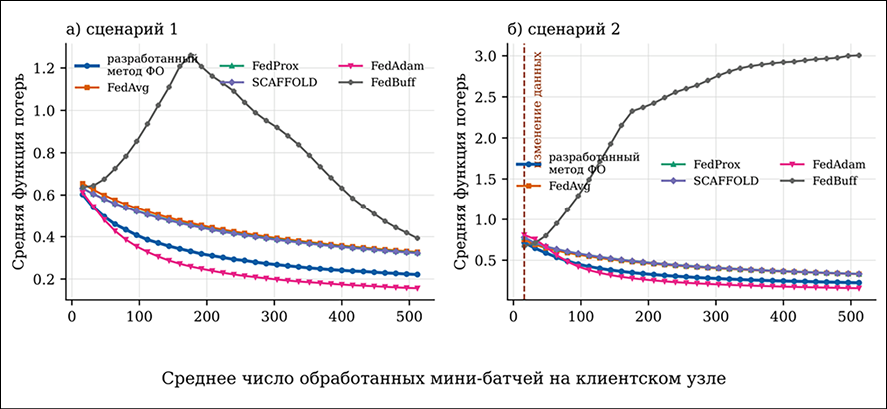
Рис. 2. Изменение функции потерь: а) сценарий 1; б) сценарий 2 Примечание: составлен авторами по результатам данного исследования
Для сравнения качества обучения проведены стендовые испытания на задаче, сформированной на основе MNIST, с девятью клиентами и бюджетом 512 мини-батчей на клиента. В сценарии 1 моделировалась выраженная неоднородность клиентских данных, в сценарии 2 – изменение их распределения в процессе обучения. На рис. 2 сопоставлена функция потерь (бинарная перекрестная энтропия) при одинаковом объеме локальных вычислений. В обоих сценариях конечное значение функции потерь для разработанного метода оказалось ниже, чем для FedAvg, FedProx, SCAFFOLD и FedBuff, и выше, чем для FedAdam.
Коммуникационные затраты той же серии экспериментов сопоставлены на рис. 3. Учтен накопленный объем прикладных сообщений между клиентами, туманными узлами и глобальным сервером. К концу сценариев 1 и 2 при разработанном методе передано соответственно 14,97 и 16,12 МиБ, при FedAvg – 39,56 и 39,57 МиБ. Среди шести сравниваемых методов наименьший объем сообщений получен при разработанном методе. Меньшая потеря FedAdam сопровождается увеличением обмена в 2,63 и 2,44 раза относительно разработанного метода.
Вклад отдельных компонентов в разработанном методе оценен путем их поочередного отключения (абляции) при одинаковых данных, исходных параметрах модели и вычислительном бюджете (табл. 3). Через n обозначено число пар запусков, WAN – объем обмена между туманными узлами и глобальным сервером. Изменения рассчитаны для полного метода относительно варианта с отключением: отрицательное значение означает уменьшение объема обмена или потери. Потеря за весь интервал рассчитывается как нормированная площадь под кривой после исключения начального этапа; средний участок соответствует 25–75 % интервала, завершающий – последним девяти точкам.
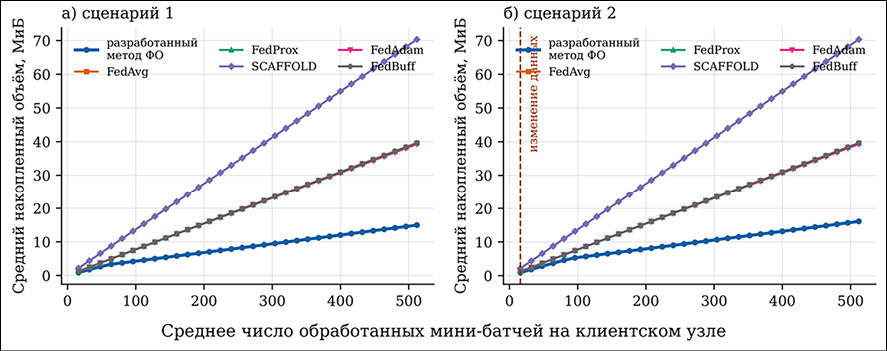
Рис. 3. Накопленный объем прикладных сообщений: а) сценарий 1; б) сценарий 2 Примечание: составлен авторами по результатам данного исследования
Таблица 3
Абляция компонентов: относительное изменение WAN и функции потерь, %
|
Отключаемый компонент |
Пар, n |
WAN |
Тестовая потеря (конечная) |
Средняя потеря |
||
|
Весь интервал |
Средний участок |
Завершающий участок |
||||
|
Контроль задержек |
51 |
–1,87 |
+0,37 |
+0,91 |
+1,14 |
+0,29 |
|
Граница Esafe |
11 |
–20,79 |
–0,96 |
–0,45 |
–0,59 |
–0,86 |
|
Оценка Кантелли |
51 |
+0,00070 |
–0,72 |
–3,71 |
–6,03 |
–1,20 |
|
Обратная связь |
151 |
+0,00252 |
–0,23 |
–1,30 |
–2,06 |
–0,45 |
|
Проверка по кривизне (HVP) |
31 |
–28,11 |
–14,86 |
–52,63 |
–30,25 |
–48,19 |
|
Версии и проверяемый кэш |
11 |
–51,76 |
–2,06 |
–3,11 |
–3,60 |
–2,33 |
|
Туманный уровень |
11 |
–98,12 |
0,00 |
0,00 |
0,00 |
0,00 |
Примечание: составлена авторами на основе полученных данных в ходе исследования.
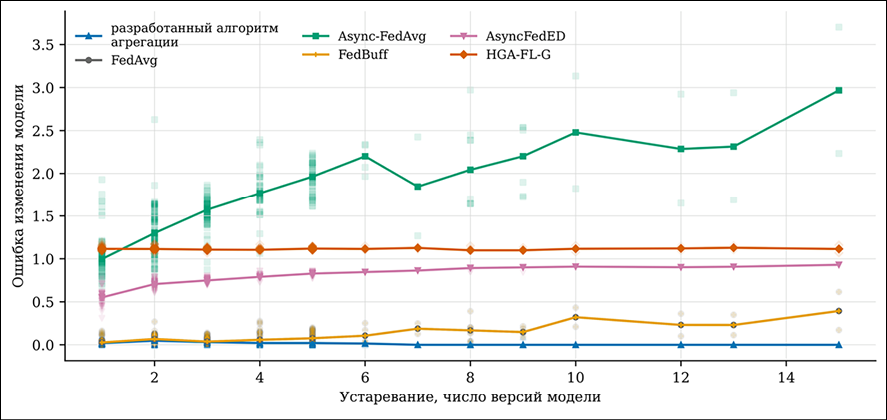
Рис. 4. Расчетная ошибка обработки агрегата после повторного формирования в зависимости от версионного устаревания Примечание: составлен авторами по результатам данного исследования
Таблица 4
Качество и расчетная полезная нагрузка алгоритмов при имитации взаимодействия клиентов
|
Набор и режим нагрузки |
Алгоритм |
Сбалансированная доля правильных ответов |
Критерий Брайера |
Полезная нагрузка, КиБ |
|
ACSIncome, умеренный |
Разработанный алгоритм |
0,7509 |
0,1740 |
17,11 |
|
ACSIncome, умеренный |
FedAvg MLP |
0,7161 |
0,1773 |
20,63 |
|
Electricity, тяжелый |
Разработанный алгоритм |
0,8277 |
0,1373 |
37,62 |
|
Electricity, тяжелый |
FHT |
0,8294 |
0,1515 |
133,73 |
|
Fed-Heart, тяжелый |
Разработанный алгоритм |
0,8011 |
0,1450 |
95,84 |
|
Fed-Heart, тяжелый |
FHT |
0,5491 |
0,2378 |
Примечание: составлена авторами на основе полученных данных в ходе исследования.
Для каждой абляции выбран первичный показатель; далее указаны значения для метода по рис. 1 и без компонента, эффект и 95 %-ный ДИ: контроль задержек, WAN – 2 803 154 / 2 856 668 байт, −1,87 % [−2,37; −1,38] %; граница Esafe, конечная потеря – 0,176189 / 0,177897, −0,96 % [−1,12; −0,82] %; оценка Кантелли, потеря на среднем участке – 0,180267 / 0,191836, −6,03 % [−6,32; −5,74] %; обратная связь – 0,177885 / 0,181621, −2,06 % [−2,79; −1,30] %; HVP, потеря за весь интервал – 0,160794 / 0,339451, −52,63 % [−55,32; −49,92] %; версии и кэш, завершающий участок – 0,172813 / 0,176938, −2,33 % [−2,77; −1,91] %; туманный уровень, WAN – 531 580 / 28 322 752 байт, −98,12 % [−98,13; −98,12] %. При контроле задержек снижение WAN сопровождалось ростом конечной потери на 0,37 % [0,13; 0,63] %, что отражает компромисс между обменом и качеством.
Точность отбора агрегатов проверена на 340 сохраненных событиях обучения логистической модели MNIST при одном локальном шаге. При η = 0,004 и δagg = 0,1 проверка по (20) ошибочно применила 1 из 84 недопустимых агрегатов и отклонила 2 из 256 допустимых. На рис. 4 ошибка обработки сопоставлена с числом изменений версии модели; для отклоненных агрегатов она рассчитана по сохраненному эталонному обновлению текущей версии. Опыт оценивает точность отбора и расчетную ошибку.
В табл. 4 разработанный алгоритм сопоставлен с FedAvg-MLP на ACSIncome и с FHT на Electricity и Fed-Heart по 30, 10 и 10 парным запускам соответственно. Расчетная полезная нагрузка включает числовые параметры и структурные счетчики без транспортных накладных расходов. У разработанного алгоритма она ниже на ACSIncome и Electricity, но в среднем выше на Fed-Heart. Сбалансированная доля правильных ответов выше на ACSIncome и Fed-Heart, а на Electricity в среднем ниже, чем у FHT, на 0,17 процентного пункта.
95 %-ные ДИ в эксперименте получены процентильным бутстрепом. На ACSIncome (30 пар) разработанный алгоритм повысил сбалансированную точность на 0,49 п. п. [0,33; 0,64], снизил критерий Брайера на 0,0033 [0,0028; 0,0037] и полезную нагрузку примерно на 3,52 КиБ. На Electricity (10 пар) точность различалась неустойчиво: −0,17 п. п. [−1,68; 1,97], при этом критерий Брайера снизился на 0,0142 [0,0102; 0,0179], а нагрузка – примерно на 96,11 КиБ. На Fed-Heart (10 пар) точность выросла на 25,20 п. п. [18,60; 30,09], критерий Брайера снизился на 0,0928 [0,0782; 0,1055].
Заключение
Разработаны метод адаптивного федеративного обучения, алгоритм иерархического агрегирования и алгоритм инкрементального дерева решений. Метод учитывает распределение возраста обновлений и кривизну функции потерь при выборе шага обучения и числа локальных шагов; для глобальной модели получены характеристическое уравнение и условие критического шага. В экспериментах совокупный объем прикладных сообщений относительно FedAvg сокращен на 59,3–62,2% при меньшей конечной потере. При проверке агрегатов ошибочно применен 1 из 84 недопустимых и отклонены 2 из 256 допустимых; снижение критерия Брайера составило 1,9; 9,4 и 39,0% на ACSIncome, Electricity и Fed-Heart соответственно. Дальнейшие исследования целесообразно направить на расширение области применимости метода для различных распределений данных и задержек.
Conflict of Interest
Funding
Bibliographic Reference
URL: https://top-technologies.ru/en/article/view?id=40927 (accessed: 12/10/2026).