ПОДХОД К КОНФИГУРАЦИИ И ОПТИМИЗАЦИИ ИМИТАЦИОННЫХ МОДЕЛЕЙ ОРГАНИЗАЦИОННЫХ СИСТЕМ
Введение
Имитационное моделирование давно используется как способ проверки управленческих решений в сложных системах [1] – и организационные системы здесь не исключение: им свойственны сложная структура, стохастичность протекающих процессов и заметный разброс входных данных [2]. Проблема в том, что прямая оптимизация таких моделей предполагает множество прогонов для перебора конфигураций параметров, а значит – существенные вычислительные затраты. Ситуацию осложняют и сами особенности организационных систем: помимо стохастичности и изменчивости процессов для них характерны высокая размерность пространства параметров, нелинейные зависимости с множеством локальных экстремумов, динамичность, нестационарность, а зачастую и несколько конкурирующих критериев управления [3]. Вместе эти факторы задают набор вычислительных и методологических ограничений, которые необходимо учитывать при построении методов оптимизации.
В этих условиях применение методов искусственного интеллекта, в частности суррогатного (прокси-) моделирования, позволяет существенно снизить вычислительную нагрузку. Суть прокси-моделирования заключается в замещении исходной имитационной модели ее многомерной аппроксимацией, описывающей зависимости между входными и выходными параметрами на основе статистических закономерностей [4]. Использование прокси-моделей позволяет значительно ускорить оценку целевых показателей при сохранении приемлемой точности [5]. Далее используется термин «прокси-модель» (синонимы – суррогатная, аппроксимирующая модель).
В данной работе предлагается архитектура универсальной системы для конфигурации и оптимизации имитационных моделей организационных систем на основе гауссовских процессов, выступающих в качестве суррогатной модели. Под конфигурацией имитационной модели понимается выбор и задание совокупности значений управляющих параметров модели, определяющих сценарий ее функционирования и поведение моделируемой системы. Предлагаемый подход не привязан к конкретной предметной области и рассчитан на широкий класс задач имитационного моделирования. Далее в статье излагаются концептуальная архитектура системы и общий алгоритм работы модуля оптимизатора с адаптивным формированием обучающей выборки.
Цель исследования – предложить подход к конфигурации и оптимизации имитационных моделей организационных систем, позволяющий сократить вычислительные затраты, не теряя в качестве принимаемых решений, что и демонстрируется на тестовом сценарии.
Материалы и методы исследования
По результатам обзора литературы для дальнейшего рассмотрения были отобраны наиболее распространенные методы суррогатного моделирования на основе машинного обучения (ML): гауссовские процессы, случайные леса, разложение по полиномиальному хаосу и многомерная линейная интерполяция – все они хорошо подходят для аппроксимации сложных нелинейных зависимостей [6].
Гауссовские процессы (GP) – вероятностная модель, в которой значения функции задаются многомерным нормальным распределением через функцию среднего и ковариационную функцию [7]. Кроме аппроксимации, такой подход дает оценку неопределенности предсказаний. Случайный лес устроен иначе: строится ансамбль решающих деревьев на подвыборках данных со случайными подмножествами признаков, а итоговый прогноз получается усреднением по всем деревьям – за счет этого метод обеспечивает высокую точность аппроксимации при наличии существенно нелинейных зависимостей между входными параметрами и выходными показателями модели [8]. Разложение по полиномиальному хаосу (PCE) раскладывает случайную функцию по ортогональным полиномам, соответствующим распределениям входных параметров [9]. А многомерная линейная интерполяция строит аппроксимацию по значениям функции в узлах регулярной сетки, интерполируя отдельно по каждой размерности пространства [10].
Методы также сравнивались по вычислительной сложности обучения и получения предсказаний: она зависит прежде всего от размерности задачи и определяет, насколько быстро можно построить прокси-модель и подключить ее к оптимизационному контуру. По этой метрике гауссовские процессы обходятся кубической сложностью O(n3), случайным лесам требуется O(n log(n)·m·d), полиномиальному хаотическому расширению – O(P·n), а многомерной линейной интерполяции – O(2d·n), то есть сложность растет экспоненциально с ростом размерности пространства параметров. Это особенно важно именно для имитационных моделей: они и без того вычислительно затратны, требуют множества прогонов и оперируют пространствами параметров высокой размерности.
Одним из способов справиться с этими ограничениями остается суррогатное моделирование, воплощающее идею «машинно-обучаемых ассистированных симуляций» [11]. Работает это так: суррогатная модель встраивается прямо в контур оптимизации, и часть обращений к «тяжелой» имитационной модели подменяется ее быстрой аппроксимацией, а весь процесс выстраивается цепочкой взаимосвязанных шагов.
Если сравнивать все четыре метода, у гауссовских процессов сразу несколько сильных сторон: точная интерполяция обучающих данных, встроенная оценка неопределенности, приемлемые результаты даже на небольших выборках [12]. Альтернативные методы, как правило, не обладают всей совокупностью перечисленных свойств: одни не обеспечивают вероятностной интерпретации получаемых результатов, другие плохо масштабируются с ростом размерности пространства параметров. Отсюда и компромисс, который приходится закладывать при выборе алгоритма: между точностью модели, нужным объемом данных, необходимостью оценивать неопределенность и тем, насколько результат вообще поддается интерпретации [13, 14]. Для задач с активным адаптивным сэмплированием гауссовские процессы по-прежнему выглядят предпочтительнее [15]; теоретическую основу этого выбора и самой идеи суррогатного моделирования составляют работы [16–18].
Результаты исследования и их обсуждение
По итогам исследования была построена концептуальная архитектура системы для конфигурации и оптимизации имитационных моделей организационных систем на базе суррогатного моделирования. В ее основе лежит связка имитационной модели с интеллектуальным оптимизатором внутри единого итеративного контура – именно она обеспечивает автоматизированный поиск эффективных конфигураций параметров. Систему образуют три ключевых компонента: имитационная модель, оптимизатор и встроенная в него прокси-модель. В реализованной архитектуре используется гауссовский процесс с радиально-базисным (RBF) ядром, параметры которого (масштаб и длины корреляции) обучаются путем максимизации логарифма маргинального правдоподобия. Перед обучением прокси-модели входные параметры управления и значения целевой функции подвергаются стандартной нормализации. Стохастический характер имитационной модели учитывается за счет включения аддитивного шумового члена в ковариационную функцию. Для каждой конфигурации параметров выполняется один прогон имитационной модели по нескольким репликациям, что соответствует сценарию оптимизации вычислительно затратных стохастических систем. Критерием остановки оптимизационного процесса является достижение заданного вычислительного бюджета (итераций запуска имитационной модели), либо отсутствие значимого улучшения значения целевой функции.
Предложенная структура отражает общий принцип функционирования системы, основанный на взаимодействии имитационной модели и оптимизационного модуля. Оптимизатор, реализованный на основе методов машинного обучения (с ядром на гауссовских процессах), формирует параметры управления и генерирует новые сценарии, которые передаются в имитационную модель. Управляя прогонами модели, оптимизатор генерирует исходные данные для обучения прокси-модели, и после обучения прокси-модель подбирает оптимальное решение. Имитационная модель, в свою очередь, использует как управляющие, так и конфигурационные параметры и возвращает выходные данные, характеризующие качество функционирования системы (рис. 1).
Таким образом, система выполняет двойственную функцию: конфигурирует имитационную модель и оптимизирует результаты ее работы. Под конфигурацией в данном случае понимается генерация входных данных модели (параметров управления), а также управление прогонами, необходимыми для обучения и дообучения прокси-модели.
Оптимизатор обучается на основе обучающей выборки, сформированной из n прогонов имитационной модели. Каждый прогон включает m репликаций, что позволяет учитывать стохастический характер системы. Результатом отдельного запуска является значение оптимизируемого показателя, тогда как результат прогона определяется как усредненное значение данного показателя по всем m репликациям.
После завершения этапа обучения выполняется проверка качества работы оптимизатора на основе анализа значения коэффициента детерминации R2. В случае, если значение метрики не соответствует заданному пороговому уровню, инициируется процесс дообучения, основанный на расширении обучающей выборки за счет дополнительных прогонов имитационной модели.
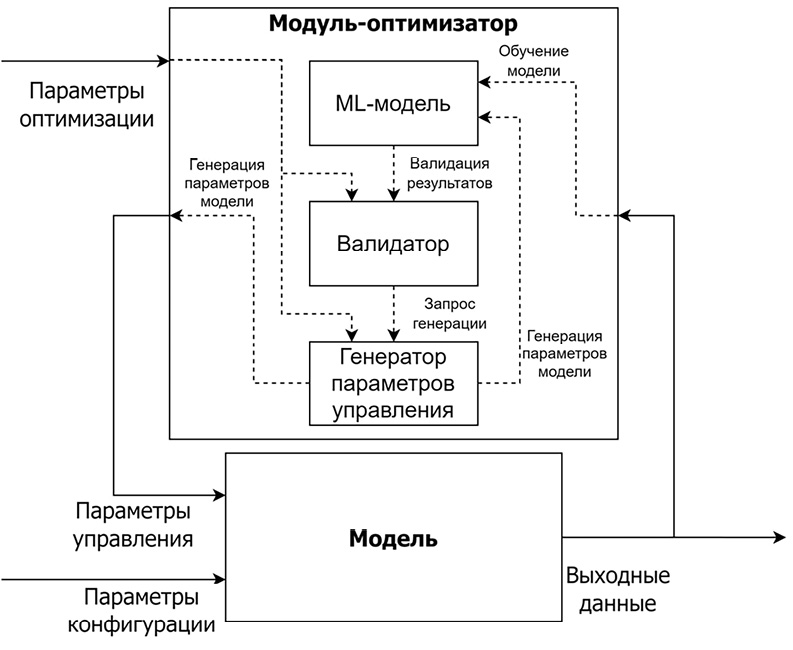
Рис. 1. Концептуальная схема системы конфигурации и оптимизации имитационных моделей Примечание: составлен авторами по результатам данного исследования
Процесс обучения и дообучения носит итеративный характер: после каждого этапа дообучения выполняется повторная оценка качества модели, и цикл продолжается до достижения заданных критериев. Общий алгоритм работы модуля оптимизатора представлен на рис. 2.
Предлагаемый алгоритм основан на построении прокси-модели имитационной модели и состоит из трех последовательных этапов: первичного обучения прокси-модели, ее итерационного дообучения и финальной оптимизации. На вход алгоритм получает от оптимизатора исходные данные: пространство варьируемых параметров с ограничениями, целевые показатели, число репликаций и допустимый вычислительный бюджет. На этапе первичного обучения для каждой точки начального плана эксперимента выполняется прогон имитационной модели в нескольких репликациях. Полученные показатели усредняются по репликациям, чтобы снизить влияние стохастической составляющей. По результатам формируется начальная обучающая выборка (1), на которой обучается статистическая модель, выступающая в роли прокси-модели. Далее начинается этап дообучения. В начале каждой итерации проверяется выполнение критериев качества обучения (4). Если они не выполнены, в новых точках проводятся прогоны имитационной модели (2), результаты усредняются по репликациям (3) и добавляются в обучающую выборку, после чего прокси-модель дообучается (3). Цикл повторяется до достижения требуемого качества аппроксимации. После этого выполняется финальная оптимизация: на прокси-модели ищется оптимум (6), и для полученного набора точек-кандидатов проводятся прогоны имитационной модели (7). Так, предсказания прокси-модели проверяются на исходной модели. Затем повторно проверяются критерии качества обучения (4). Если они нарушены, алгоритм возвращается к этапу дообучения, и новые точки дополняют выборку в наиболее перспективной области пространства параметров. Если критерии выполнены, проверяется критерий остановки (8), то есть достижение вычислительного лимита. Пока лимит не исчерпан, алгоритм продолжает итерации дообучения и уточняет как прокси-модель, так и найденное решение. При достижении лимита выводятся результаты оптимизации.
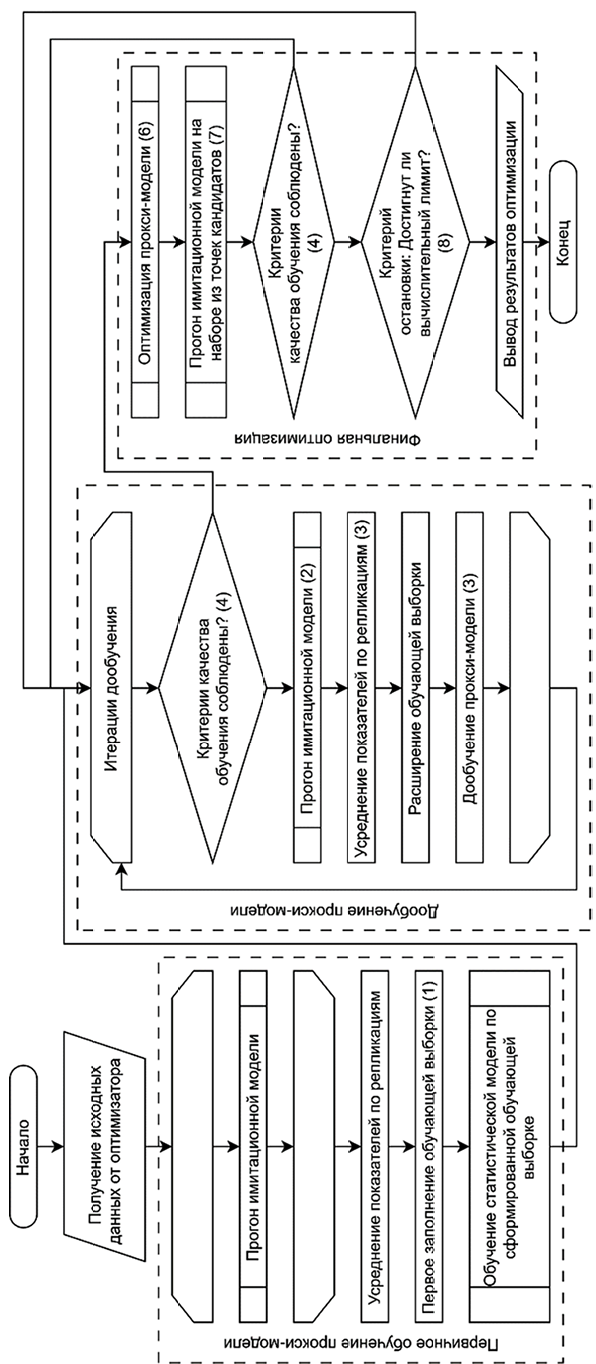
Рис. 2. Общий алгоритм работы модуля оптимизатора Примечание: составлен авторами по результатам данного исследования
Таким образом, в работе методы суррогатного моделирования применяются не для анализа внутренней структуры имитационной модели или идентификации законов распределения, а для аппроксимации зависимости между параметрами управления и агрегированными выходными показателями, полученными в результате многократных прогонов модели. В рамках исследования гауссовские процессы не рассматриваются как средство проверки корректности или адекватности имитационной модели. Напротив, имитационная модель априори принимается как более точное и детализированное представление исследуемой системы. Имитационная модель является «источником истины» и единственным средством оценки конфигураций, а прокси-модель – аппроксиматором, ускоряющим поиск. Она не выполняет функций оптимизатора или конфигуратора и используется только для управления перебором конфигураций, адаптивного формирования обучающей выборки и сокращения вычислительных затрат.
В качестве тестовой модели для оптимизатора была разработана дискретно-событийная имитационная модель одного маршрута пассажирского транспорта, предназначенная для анализа влияния конфигурации маршрута на показатели эффективности процесса. Управляли моделью через два параметра: характеристики подвижного состава (тип и вместимость автобуса) и интенсивность его выхода на линию, причем оба задавались в пределах, допустимых эксплуатационными условиями. Ограничивали задачу вместимость подвижного состава, неотрицательность интервалов движения и фиксированная длительность моделируемого периода. За оптимальность отвечал единый агрегированный показатель – свертка нескольких частных критериев (среднее время ожидания пассажиров на остановках, число перевезенных пассажиров, загрузка подвижного состава, влияние маршрута на дорожную обстановку), полученная после их нормализации.
Границы допустимых значений управляющих параметров задают стартовую обучающую выборку; качество построенной по ней прокси-модели затем проверяется метрикой RMSE. Где именно аппроксимация ошибается больше всего, показывает метод роя частиц – в этих зонах параметрического пространства и генерируются точки для дополнительных прогонов имитационной модели и дообучения прокси-модели. А сама модель работает на уровне событий: выход автобуса на линию, его прибытие на остановку – и на каждом пересчитывает интервалы движения, число подошедших пассажиров, среднее время ожидания, посадку и высадку с учетом вместимости транспорта.
За качеством прокси-модели следят две метрики – R2 и RMSE, посчитанные отдельно по каждому компоненту целевой функции. Порогом служит R2 не ниже 0,95 и отсутствие заметного падения RMSE на последних итерациях дообучения – как только оба условия выполнены, дообучение останавливается. K-кратную кросс-валидацию, отдельную тестовую выборку и доверительные интервалы метрик здесь сознательно не использовали – эта проверка оставлена на будущее.
Для этого сценария взяли 700 точек, накопленных по прогонам имитационной модели, и на них обучили прокси-модель. Точность аппроксимации отслеживали по R2 и среднеквадратичной ошибке (RMSE) – отдельно по каждому выходному показателю целевой функции. По метрике RMSE оценивали число обслуженных пассажиров, загруженность автобусов (относительное отклонение в процентах), среднее время ожидания пассажиров (в минутах) и влияние маршрута на транспортный поток. Коэффициент детерминации R2 рос у прокси-модели быстро: высокое качество аппроксимации достигалось уже на начальных итерациях: при объеме обучающей выборки 50 точек значения R² составляли около 0,99; после 100 итераций рост замедлился, но ниже 0,97 показатель не опускался. Наилучшее качество аппроксимации получено для параметров пассажиропотока: значение коэффициента детерминации составило 0,999. Дальше выборку наращивали, но точность менялась уже незначительно: около 100 прогонов имитационной модели оказывалось достаточно, чтобы прокси-модель воспроизводила поведение системы в этой конфигурации с приемлемой точностью. Общее число прогонов имитационной модели и соответствующее время вычислений возрастают линейно с увеличением размера обучающей выборки. Зависимости RMSE от размера обучающей выборки для значений до 180 обучающих точек подробно приведены на рис. 3.
Приведенные зависимости RMSE от размера обучающей выборки свидетельствуют о достижении практической сходимости прокси-модели и позволяют определить достаточный объем обучающих данных, обеспечивающий сокращение числа вычислительно затратных прогонов имитационной модели по сравнению с базовым методом прямого перебора параметров без существенной потери точности оценки целевой функции.
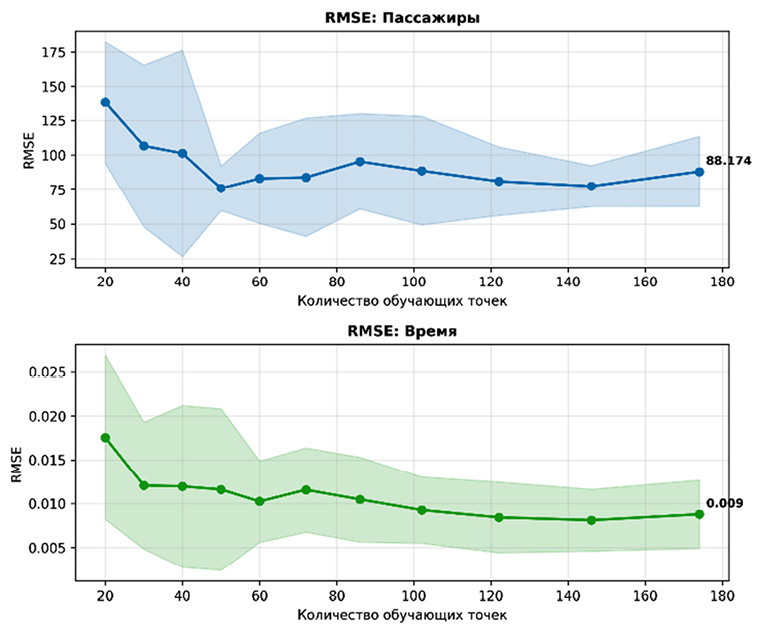
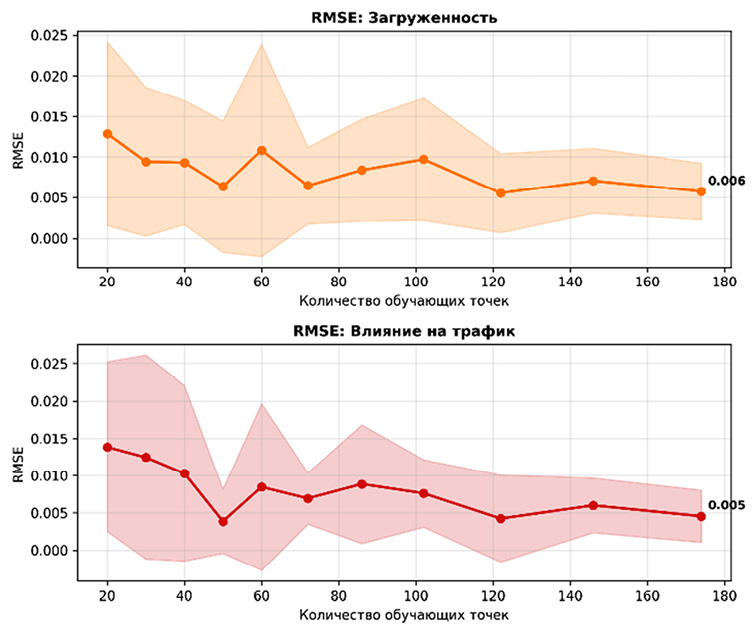
Рис. 3. Оценка качества предсказаний прокси-модели (ось X – число обучающих точек, то есть уникальных конфигураций параметров; ось Y – RMSE в единицах показателя: пассажиры – чел., загрузка – %, время ожидания – мин) Примечание: составлен авторами по результатам данного исследования
Анализ зависимости RMSE от объема обучающей выборки показывает, что для всех рассматриваемых выходных показателей наблюдается тенденция к снижению ошибки аппроксимации с увеличением числа обучающих точек и последующей стабилизации ее значений. Для оцениваемых параметров ошибка аппроксимации быстро уменьшается и после формирования обучающей выборки объемом порядка 100–120 точек остается практически неизменной. Оценка указанных метрик позволила количественно охарактеризовать точность прокси-модели по каждому компоненту целевой функции и подтвердить ее пригодность для использования в оптимизационном контуре. Полученные значения R2 и RMSE использовались не только для контроля качества аппроксимации, но и в качестве критерия остановки дообучения, что обеспечило адаптивное формирование обучающей выборки. Научная значимость работы заключается в разработке универсальной архитектуры системы и алгоритма адаптивного формирования обучающей выборки на основе суррогатного моделирования, которые не зависят от предметной области и могут быть интегрированы с различными имитационными моделями. Тестовая модель является частным случаем имитационной модели организационной системы. Поскольку предложенный алгоритм не использует предметно-ориентированные особенности транспортной модели и взаимодействует с имитационной моделью исключительно через входные параметры и выходные показатели, полученные результаты обосновывают возможность его применения к широкому классу имитационных моделей организационных систем аналогичной структуры.
Подход имеет ряд ограничений. Обучение гауссовского процесса характеризуется сложностью O(n3), что ограничивает его применение при размерности свыше 20–30 параметров [15, 16]. Апробация выполнена на одной дискретно-событийной модели. Базовым методом сравнения служил прямой перебор; сопоставление с байесовской оптимизацией и эволюционными алгоритмами по числу прогонов, времени расчета и качеству решения не проводилось [18].
Заключение
В работе предложен подход к конфигурации и параметрической оптимизации имитационных моделей организационных систем на основе суррогатного моделирования с использованием гауссовских процессов. Разработанная система реализована в виде надстройки над имитационной моделью и ориентирована на автоматизацию настройки параметров управления и поиск эффективных конфигураций при ограниченных вычислительных ресурсах. Апробация подхода выполнена на тестовой дискретно-событийной модели одного маршрута наземного пассажирского транспорта, что позволило исследовать его основные свойства, включая сходимость обучения прокси-модели и эффективность оптимизационного контура в условиях ограниченного числа прогонов имитационной модели. В то же время обобщение результатов на другие классы организационных систем, многопараметрические сценарии и альтернативные постановки оптимизационных задач требует проведения дополнительных вычислительных экспериментов и рассматривается как направление дальнейших исследований.
Конфликт интересов
Финансирование
Библиографическая ссылка
URL: https://top-technologies.ru/article/view?id=40975 (дата обращения: 10.11.2026).
DOI: https://doi.org/10.17513/snt.40975