КОНТРАСТИРОВАНИЕ ПАРАМЕТРОВ ОБУЧЕННОЙ НЕЙРОННОЙ СЕТИ
Введение
Большие языковые модели (Large Language Models LLM), в настоящее время повсеместно внедряются в производственные процессы. В работе [1] предложена система анализа неструктурированных документов Docu Mind AI с использованием LLM. Интеграция методов оптического распознавания символов и синтаксического анализа обеспечивает поддержку графических и векторных форматов для запросов в режиме реального времени. В обзоре [2] рассматриваются задачи преобразования текста в SQL и SQL в текст для доступа к структурированным данным и анализируются возможности применения этих методов в сфере кибербезопасности, малоресурсных систем управления базами данных и корпоративной аналитики. В работе [3] были сгенерированы комментарии к программному коду с помощью модели GPT-3.5, затем выявлялись ошибки с использованием набора данных Defects 4J. Предложенный подход позволяет обнаружить на 19–94% больше реальных ошибок, в зависимости от используемых метрик.
В [4] сравнивались модели CNN обнаружения, классификации и сегментации изображений с COVID-19, разработанная нейронная сеть достигает точности в 93%, что доказывает эффективность CNN в задачах диагностики и прогноза COVID-19. Целью исследования [5] была разработка и оценка LLM на основе Llama 3-8B для создания текстовых заключений по результатам магнитно-резонансной томографии и компьютерной томографии. Несмотря на то, что модель продемонстрировала высокую эффективность, такие её недостатки, как предвзятость в наборе данных, ограниченное разнообразие выборки, отсутствие клинического мышления и потребность в больших вычислительных ресурсах, требуют дальнейшей доработки и проверки в реальных условиях.
Целью исследования [6] было создание упрощенного и интерпретируемого показателя для отличия текстов, созданных LLM, от текстов, написанных человеком. Оценка показала, что разработанный критерий на основе триграмм-косинус-дельта неизменно демонстрировал наивысшую производительность в различных экспериментальных условиях, достигнув значения Adjusted Rand Index примерно 0,70, что выше базового показателя RuModernBERT (ARI ≈ 0,28).
В работе [7] использовались методы глубокого обучения для обнаружения вредоносного трафика, зашифрованного с помощью криптографии, без его расшифровки, что обеспечивает высокую точность обнаружения. Предлагается метод, сочетающий обработку естественного языка и машинное обучение, метод обнаружения на основе TF-IDF для построения модели обнаружения.
Для анализа сетевого трафика в [8] предложена архитектура Edge-Mamba, объединяющая линейную State Space-архитектуру (модель состояний) и дообучение (fine-tuning) на сетевых данных. Дана оценка переносимости между гетерогенными наборами данных. Показано, что без дообучения переносимость ограниченна (точность 65%), но при дообучении на 10% целевого набора данных точность восстанавливается до 99%. Это позволяет отнести дообучение к методам постобработки ИНС.
Некоторые методы квантования/округления предполагают преобразование дробных типов данных (таких, как float16, float32, float64) в целочисленные типы. Размерность полученных целочисленных коэффициентов всегда кратна байту, а вот их значения могут быть ограничены мощностью вплоть до единичных бит [9].
Результаты обзора [10] методов квантования, прунинга и дистилляции знаний показали, что постобучающее квантование может сократить размер модели в 3 раза и потерять не более 1.5% точности. Полученные результаты планируется использовать для дальнейшей оптимизации нейронных сетей, комбинирования методов квантования с другими методами и создания новых гибридных методов. Квантование эффективно для мобильных и IoT-устройств, где критичны требования к энергопотреблению и памяти.
В [11] рассматривается структурный прунинг без дообучения. Сеть ResNet-32 для задачи классификации CIFAR-10 удалось сократить в 4.5 раза при падении точности примерно на 10%. В работе [12] бесструктурным прунингом формировали разреженную рекуррентную нейронную сеть, которая используется в качестве модели цифрового корректора в задаче линеаризации СВЧ усилителя мощности. Разреженная модель имеет компактный вид и снижает вычислительную нагрузку на вычислителе.
Микроконтроллеры и устройства IoT [13] энергоэффективны и доступны по цене, но зачастую имеют ограниченный функционал, малый объем памяти и вычислительную мощность, а современные LLM модели могут иметь многие миллионы параметров. Это затрудняет развертывание LLM моделей на мобильных устройствах, повышает риск задержек и/или неэффективной обработки данных, что неприемлемо в приложениях автономного вождения или медицинской диагностике.
Метод сжатия [14] на основе факторизации низкого ранга с разложением по сингулярным числам разной степени сжатия снижает вычислительную нагрузку на большие языковые модели, но часто приводит к значительному снижению точности, даже при небольшой степени сжатия. Проверочные задачи показали, что при равномерном сжатии модели теряли важную синтаксическую и семантическую информацию. Для решения этой проблемы использовались алгоритмы взвешивания и фрагментарное сжатие избыточных частей модели.
В работе [15] на примере нейронной сети с функцией активации ReLu в одном скрытом слое показано, что некоторые нейроны на выходе всегда выдают нулевое значение, они никогда не генерируют никакой информации, в рассмотренных датасетах такие нейроны обнаружены, и их доля доходила до 60%. Из этого следует вывод о необходимости поиска и удаления бесполезных нейронов после процедуры обучения нейронной сети.
Процедура квантования в настоящее время применяется для всех параметров нейронной сети, в частности под квантованием функций активации понимается ограничение разрядности результата непрерывных функции вплоть до целых чисел.
Цель исследования – демонстрация возможности квантования/контрастирования всех параметров нейронной сети, в том числе и входного вектора, и упрощения структуры ИНС в результате детального анализа результатов контрастирования без потери точности. Научная новизна исследования состоит в том, что при замене непрерывных функций активации на многозначные логические значность входа и выхода может различаться.
Материалы и методы исследования
В таблице 1 приведены характеристики рассматриваемых датасетов. Датасет DDoS Traffic расположен по адресу [16]. Строка «Dest IP» содержит адреса в форматах IPv4 и IPv6, а строка «Highest Layer» десять названий сетевых протоколов.
Столбцы датасета Water Quality and Potability [17] содержат дробные числа с точностью до 18 десятичных чисел, что явно избыточно. На сайте размещения (общедоступный ресурс kaggle) в обсуждениях этого датасета высказывается мнение, что он полностью синтетический.
Строковые и константные столбы датасета DDoS_Dataset [18] игнорируются, дробные типы данных отсутствуют, целевой параметр троичный.
Датасет UNSW_NB15 [19], в отличие от предыдущих, не сбалансирован по целевому параметру, который содержит перечислимый тип данных из десяти категорий.
В таблице 2 сравниваются структуры ИНС, их сложность убывает от первого столбца к последнему, в скрытых слоях используется функция активации ReLu.
Таблица 1
Характеристики датасетов
|
Название |
Количество строк |
Количество столбцов |
Тип данных |
Значность целевого столбца |
|||
|
бинарный |
целочисленный |
дробный |
перечислимый |
||||
|
ddos-traffic |
852585 |
9 |
3 |
3 |
1 |
2 |
2 |
|
Water |
3276 |
10 |
1 |
9 |
2 |
||
|
DDoS_Dataset |
151202 |
23 |
2 |
10 |
11 |
3 |
|
|
UNSW_NB15 |
130460 |
29 |
9 |
12 |
7 |
1 |
10 |
Примечание: составлено авторами на основе источников [16-19].
Таблица 2
Сравнение структур ИНС
|
Слой |
UNSW_NB15 |
ddos-traffic |
Water |
DDoS_Dataset |
|
Dense |
256 |
|||
|
Dropout |
0,3 |
|||
|
Dense |
256 |
80 |
||
|
Dropout |
0,3 |
- |
||
|
Dense |
128 |
40 |
||
|
Dropout |
0,3 |
- |
||
|
Dense |
64 |
20 |
16 |
|
|
Dropout |
0,3 |
- |
- |
|
|
Dense |
12 |
10 |
8 |
5 |
|
Dense |
10, softmax |
1, sigmoid |
1, sigmoid |
1, sigmoid |
Примечание: составлено авторами на основе источников [16-19].
ИНС UNSW_NB15 [20] содержит пять скрытых нейронных слоев и четыре слоя Dropout. Выходной слой содержит десять нейронов (по значности целевого параметра), функция активации softmax. После обучения значение Accuracy составляет 70,1%.
ИНС ddos-traffic [21] содержит четыре скрытых слоя, выходной нейрон бинарный, функция активации sigmoid. После обучения значение Accuracy составляет 94,42%.
В ИНС Water [22] два скрытых слоя нейронов, выход бинарный, функция активации sigmoid, упрощение структуры ИНС приводит к снижению Accuracy до 62,2%.
Самая простая ИНС – это DDoS_Dataset [23], всего один скрытый слой из пяти нейронов. Целевой столбец этого датасета троичный, но ИНС по выходу бинарная, прогнозируется наличие/отсутствие атаки. После обучения значение Accuracy составляет 100%.
Результаты исследования и их обсуждение
Исследование свойств процедуры квантования
В задачах бинарной классификации результат работы ИНС имеет битовый вид ИСТИНА/ЛОЖЬ, но до такого состояния огрубляется результат непрерывной функции активации выходного нейрона, аргументом которой является скалярное произведение векторов. Тогда представляется выгодным заменить непрерывную функцию активации на пороговую, а аргументы скалярного произведения огрубить соответствующим образом.
Для экспериментов с датасетом ddos-traffic была выбрана следующая структура ИНС: один скрытый слой в десять нейронов с функциями активации тангенс гиперболический, один нейрон в выходном слое с сигмоидальной функцией активации. Обучение нейронных сетей производилось с помощью библиотеки PyTorch, и было достигнуто значение Accuracy: 100.0%. Перед обучением датасет стандартными функциями библиотеки scikit-learn (scikit-learn.org/stable) разбивается на обучающую и тестовую выборки и масштабируется в дробных числах. Далее в электронных таблицах воспроизводился рабочий ход ИНС на тестовой выборке. На рис. 1 снимок экрана со страницей проверки вычислений.
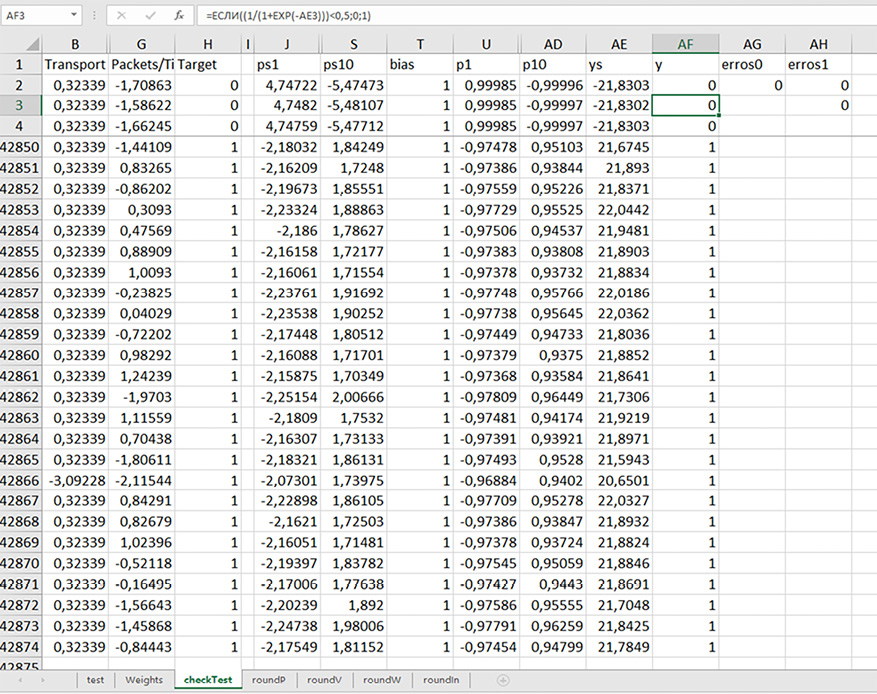
Рис. 1. Рабочий ход ИНС, функция tanh, датасет ddos-traffic Примечание: составлено авторами по результатам данного исследования
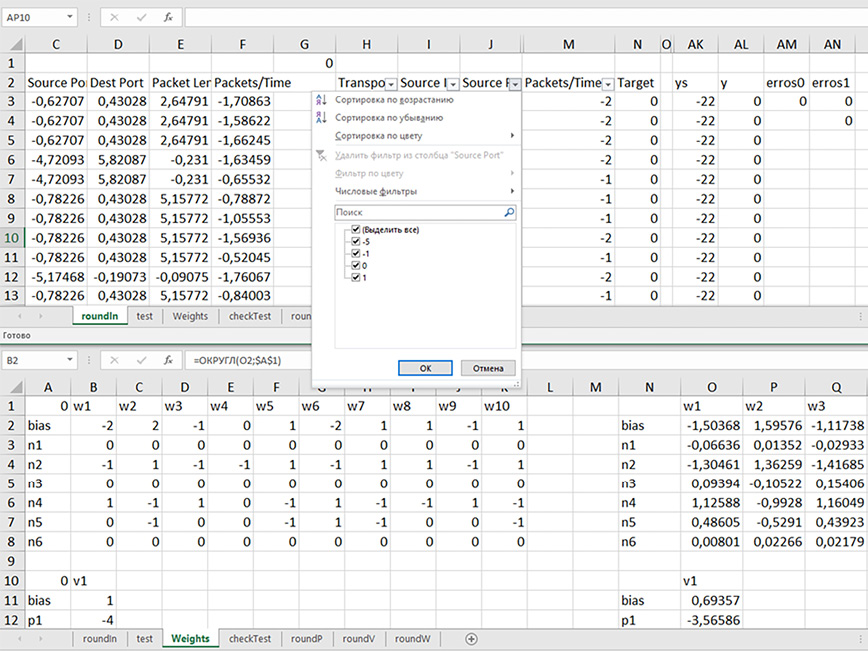
Рис. 2. Округление входа, функция tanh, датасет ddos-traffic Примечание: составлено авторами по результатам данного исследования
В столбце А находятся смещения входного слоя, в столбцах B – G экземпляры тестовой выборки: Transport Layer, Source IP, Source Port, Dest Port, Packet Length, Packets/Time (часть столбцов скрыта). В тестовой выборке 42 874 строки, масштабирование входных значений с помощью функции StandardScaler из библиотеки scikit-learn приводит к тому, что бинарные столбцы кодируются в формате дробных чисел и не симметрично, например столбец B (Transport Layer) содержит значения 0,323385775 и -3,092281818. Столбец H содержит ожидаемое значение, столбцы J – S содержат результаты скалярного произведения входов на матрицу весов скрытого слоя, обозначены как ps1…ps10.
В столбце T находятся смещения (единицы) выходного нейрона, в столбцах U – AD результаты функции активации, тангенс гиперболический, обозначены как p1…p10 (часть столбцов скрыта). Столбец AE обозначен как ys, содержит результат скалярного произведения столбцов p1…p10 на вектор весов выходного нейрона. В столбце AF результат работы ИНС – это округление до целых чисел сигмоидальной функции (строка формул) выходного нейрона, ячейки AG2 и AH2 содержат сумму ошибок для классов 0 и 1 соответственно, в ячейке AH3 находится общая ошибка сети по всем классам. Обученная ИНС ни в обучающей, ни в тестовой выборке ни разу не ошибается.
Таблица весов скрытого слоя, страница Weights (нижняя часть рис. 2), округляется до пятизначности (ячейки В2 – К8), диапазон изменения [-2, -1, 0 1, 2]. В округленной таблице весов имеются нулевые строки: n1 (ячейки В3 – К3), n3 (ячейки В5 – К5) и n6 (ячейки В8 –К8).
Это означает, что соответствующие им аргументы Transport Layer, Source Port и Packets/Time необязательны. Более того в столбце w4 имеется всего одно не нулевое значение (ячейка Е4), которое можно занулить без потери качества работы ИНС.
Контрастирование прямым ходом
Для экспериментов с датасетом Water Quality and Potability структура ИНС была упрощена, до десяти нейронов в единственном скрытом слое, функциями активации тангенс гиперболический и один нейрон в выходном слое с сигмоидальной функцией активации. Датасет делится на обучающую, тестовую и валидационную выборки в пропорции одна треть.
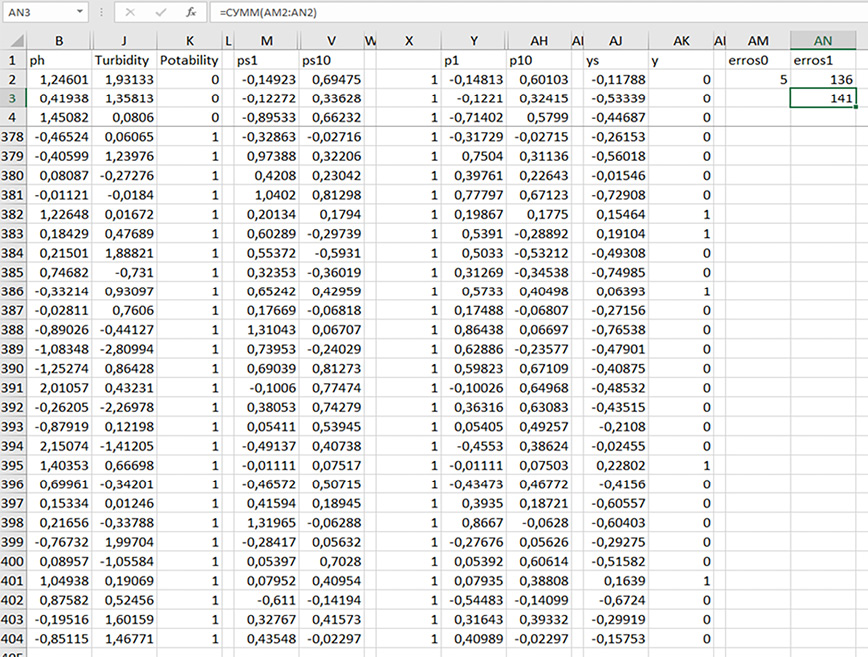
Рис. 3. Рабочий ход ИНС, функция tanh, датасет Water Quality and Potability Примечание: составлено авторами по результатам данного исследования
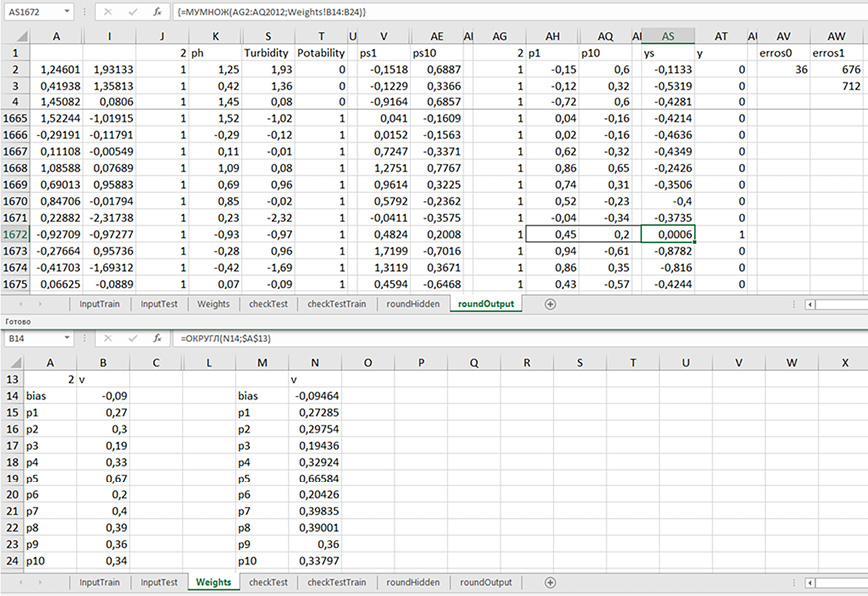
Рис. 4. Округление выхода ИНС, функция tanh, датасет Water Quality Примечание: составлено авторами по результатам данного исследования
На тестовой выборке было достигнуто значение Accuracy: 65,0%. На рис. 3 представлен снимок экрана со страницей воспроизведения рабочего хода ИНС на тестовой выборке. В ячейке AM2 находится сумма ошибок по классу ноль, в ячейке AN2 – по классу один, общая сумма ошибок – в ячейке AN3. Количество и месторасположение ошибочных экземпляров совпадает с расчетным, следовательно, воспроизведение рабочего хода в электронных таблицах реализовано корректно.
Дальнейшие расчеты производятся на полной выборке из 2011 строк, суммарное количество ошибок 713, точность в процентах – 64,55%. Здесь и далее округления параметров ИНС производятся, начиная с входных аргументов.
Верхняя часть рис. 4 демонстрирует округление столбцов p1…p10 и весов выходного нейрона (нижняя часть рис. 4) до двух знаков после запятой, коэффициенты округления в ячейках AG1 и A13 соответственно. Качество работы ИНС улучшается на один экземпляр класса 1 (выделен в строке 1672, верхняя часть рис. 4). Единственность улучшения объясняется тем, что этот экземпляр находится ближе других к разделяющей плоскости, отрицательное его значение -0,00415, а положительное 0,0006.
Сокращение матриц весов
Для экспериментов с датасетом DDoS_Dataset структура ИНС была изменена, шесть нейронов в единственном скрытом слое, его функция активации тангенс гиперболический, один нейрон в выходном слое, функция активации тангенс гиперболический. На тестовой выборке было достигнуто значение Accuracy: 100,0%. В данном случае отсутствие атаки кодируется -1, тип атаки DDoS-ACK кодируется 0, тип атаки DDoS-PSH-ACK кодируется +1. Целевые категории можно кодировать четырьмя способами: отсутствие атаки ±1, а типы атак нулем и оставшейся единицей.
На рис. 5 демонстрируется округление входных аргументов до целых чисел и весов скрытого слоя до одного знака после запятой, коэффициенты округления в ячейках L1 и A1 соответственно, кроме того, принудительно обнулены коэффициенты третьего нейрона (вместе с bias) и первых двух аргументов.
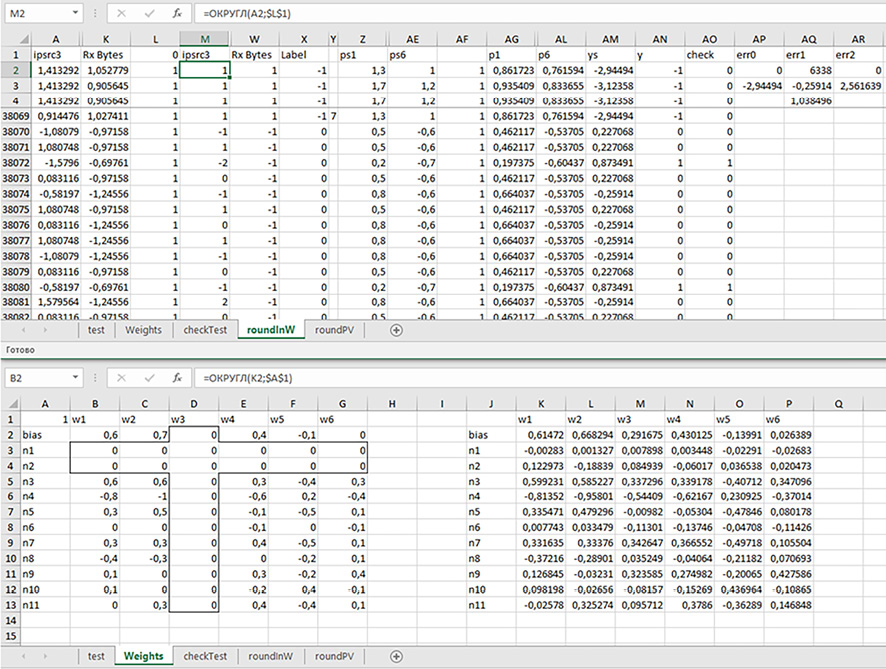
Рис. 5. Округление входов, выходная функция tanh, датасет DDoS_Dataset Примечание: составлено авторами по результатам данного исследования
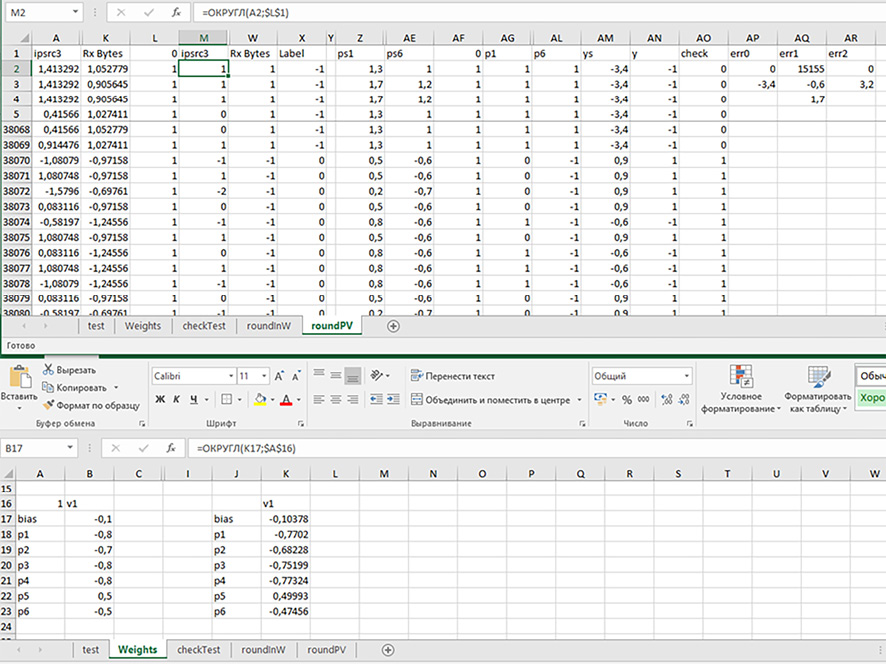
Рис. 6. Округление выхода, выходная функция tanh, датасет DDoS_Dataset Примечание: составлено авторами по результатам данного исследования
При этом тангенциальная функция активации на выходе фиксирует 6338 ошибок (ячейка AQ2). В ячейке AP3 находится максимальное значение скалярного произведения (столбец ys) для категории «нет атаки», в столбце AQ3 минимальное, а в ячейке AQ4 максимальное значение скалярного произведение для категории «атака DDoS-ACK», в ячейке AR3 минимальное значение скалярного произведения для категории «атака DDoS-PSH-ACK». Поскольку указанные диапазоны не пересекаются, то замена тангенса на пороговую, с более широкими границами, функцию активации вернет ИНС к безошибочному варианту.
Выскажем предположение, что обнулять коэффициенты матрицы скрытого слоя выгоднее по горизонтали (сокращая количество входных аргументов), например в строке n6 осталось всего два ненулевых веса.
На рис. 6 демонстрируется округление столбцов p1…p6 до целых чисел и весов выходного нейрона до одного знака после запятой, коэффициенты округления в ячейках AF1 и A16 соответственно. При этом пороговая функция активации на выходе фиксирует 15 155 ошибок (ячейка AQ2). В ячейке AP3 находится максимальное значение скалярного произведения (столбец ys) для категории «нет атаки», в столбце AQ3 минимальное, а в ячейке AQ4 максимальное значение скалярного произведения для категории «атака DDoS-ACK», в ячейке AR3 минимальное значение скалярного произведения для категории «атака DDoS-PSH-ACK». Поскольку указанные диапазоны не пересекаются, то замена тангенса на пороговую, с более широкими границами, функцию активации вернет ИНС к безошибочному варианту.
Контрастирование ИНС на примере многоклассового датасета
Для экспериментов с датасетом UNSW_NB15 структура ИНС была упрощена: десять нейронов в единственном скрытом слое с функциями активации тангенс гиперболический, один нейрон в выходном слое с функцией активации ReLu.
Было достигнуто значение Accuracy в 62.0%, не распознаются атаки DoS, Shellcode, Worms и Reconnaissance, полученный результат несколько хуже, чем у исходной ИНС, в которой имеется 5 скрытых слоев и 726 нейрона (суммарно).
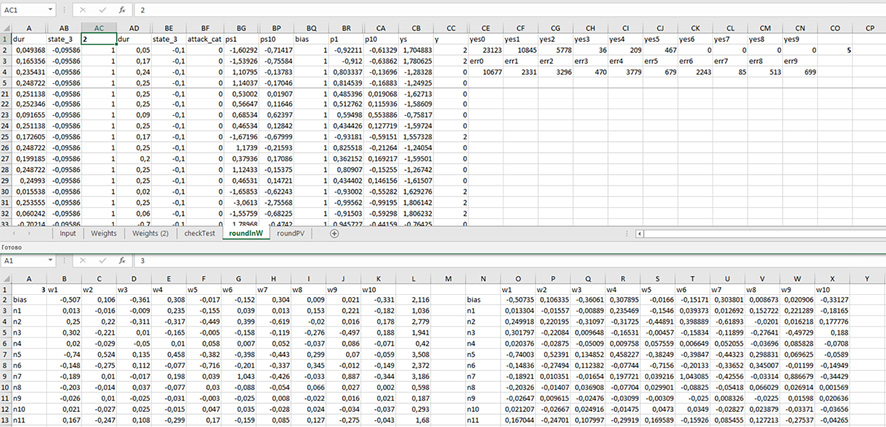
Рис. 7. Округление входа, функция tanh, датасет UNSW_NB15 Примечание: составлено авторами по результатам данного исследования
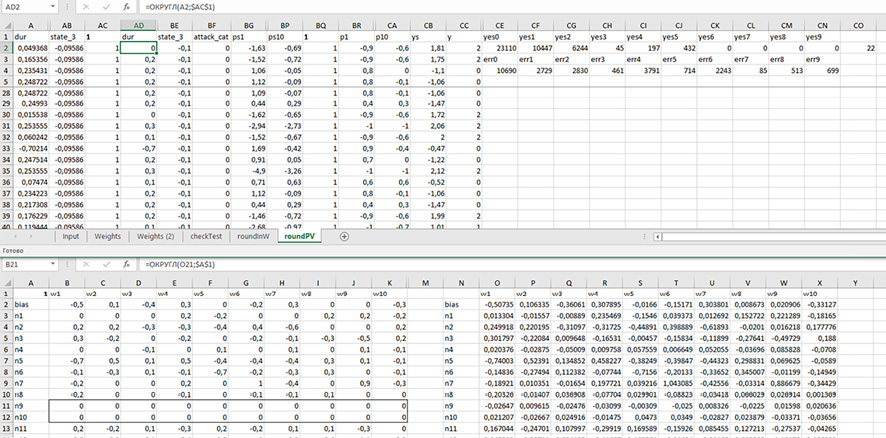
Рис. 8. Удаление входных аргументов, функция tanh, датасет UNSW_NB15 Примечание: составлено авторами по результатам данного исследования
На рис. 7 снимок экрана с округлением входных аргументов до двух знаков после запятой и весов скрытого слоя до трех знаков после запятой, коэффициенты округления в ячейках AC1 и A1 соответственно. При этом количество правильно опознанных экземпляров увеличивается на пять штук (ячейка СО2).
При повторном округлении (рис. 8) параметров нейронной сети до одного знака (веса выходного слоя не приведены для экономии места) суммарный выигрыш в 17 экземпляров по классам распределяется неравномерно, для класса 1 количество ошибок увеличивается на 398 экземпляров. Такое округление результата тангенса (столбцы р1…р10) можно заменить ступенчатой функцией активации в 21 категорию, от -1 до +1 с шагом 0,1 по вертикали. По горизонтали шаг переменный, это можно объяснить нелинейностью функции активации. На рис. 8 выделены строки, с коэффициентами матрицы первого скрытого слоя, которые обнулились в результате округления. Кроме того, имеются строки с небольшим количеством значащих коэффициентов, их обнуление также возможно. Это означает, что можно сократить мерность входного пространства алгоритмически.
Заключение
Контрастирование/округление может применяться ко всем параметрам ИНС, в том числе и ко входу. На практике контрастирование входа производится последовательным уменьшением количества значащих цифр после запятой и в матрице весов скрытого слоя, и в векторах входов.
Замена непрерывных функций активаций на ступенчатые приводит к использованию многозначных логических функций, значность которых может различаться по входу и выходу.
Методика преобразования рабочего хода ИНС в целочисленный вид предполагает сохранение/повышение достигнутой при обучении точности.
Конфликт интересов
Финансирование
Библиографическая ссылка
URL: https://top-technologies.ru/article/view?id=40965 (дата обращения: 10.11.2026).
DOI: https://doi.org/10.17513/snt.40965